SAUDAÇÕES!

Seja bem vindo à página do professor Pedro Albuquerque. Para saber mais sobre meu currículo, disciplinas ministradas e interesses de pesquisa, navegue no menu disponível no topo da página.
Mostrando postagens com marcador SVM. Mostrar todas as postagens

sexta-feira, 15 de julho de 2016

Usando a Biblioteca libSVM no R - Parte 2.


Anteriormente, vimos como executar a biblioteca LIBSVM usando o código em Java. Agora, o exercício é utilizar o código compilado em C++. No Windows é necessário que RTools esteja instalado (Dica:Instale na raiz do computador "C:\").

Esse componente do R instala juntamente com outras funções, o compilador de código fonte em C++ denominado MinGW. Qualquer outro compilador pode ser utilizado nesse exercício.

O próximo passo é obter o código fonte do programa libSVM que desejamos utilizar. Aqui, escolhemos o código desenvolvido por Youngmin Cho disponível aqui (arccos.tar.gz)! Baixe os arquivos e extrai-os em uma pasta (por exemplo C:\Blog\DeepLearning).

Em seguida, fazemos a preparação para a base de dados como no post Usando a biblioteca LIBSVM no R:

#Limpa o Workspace
rm(list=ls())
#Importa os dados German.csv 
setwd("C:\\Blog\\DeepLearning")
library(RCurl)
URL <- "https://dl.dropboxusercontent.com/u/36068691/Blog/german.csv"
x <- getURL(URL)
dados <- read.csv(textConnection(x))
#Separa o vetor de resposta
RESPONSE<-dados$RESPONSE
#Troca zero por -1
RESPONSE[RESPONSE==0]<- -1
#Remove a coluna RESPONSE
dados<-dados[,-32]
O formato exigido pelo LIBSVM deve seguir o formato: [categoria] [coluna1]:[valor1] [coluna2]:[valor2] .... Nesse sentido, fazemos:
#Função para formato libSVM
libsvm<-function(x){
  tt<-cbind(t(x),1:length(x))
  tt<-tt[tt[,1]>0,]
  str<-paste(c(rbind(tt[,2],":",tt[,1]," ")),collapse ="")
  return(str)
} 

#Cria as strings
str<-""
for(i in 1:nrow(dados)){
  x<-dados[i,]
  str<-rbind(str,libsvm(x))
}
str<-str[-1,]

#Adiciona a resposta
txt<-cbind(RESPONSE,str)
txt<-apply(txt,1,function(x) paste(x[1],x[2]))
write.table(txt,"C:/Blog/german",quote=F,row.names=F,col.names=F)
O arquivo german gerado já estará no formato do LIBSVM. Em seguida, precisamos criar os arquivos executáveis por meio do código:
#Criar os executáveis 
system("make all")
Após a criação dos arquivos o resultado que surge no console é:
Criados os arquivos, fazemos a invocação do arquivo executável svm-train:
#Em seguida executamos a função C++
parms<-c("-s 0 "," -t 5 "," -N 0 1 1 "," -d 3 "," -g 1 "," german "," saida")
#Passa os parâmetros
system(paste("svm-train ",paste(parms,collapse = "")))
Os parâmetros devem seguir a notação LIBSVM como a apresentado a seguir:
Após a execução surgem alguns resultados acerca do modelo ajustado:
Após a execução, um arquivo denominado saída é criado e todos os componentes para a previsão do modelo são inseridos nesse arquivo. Se quisermos, por exemplo, avaliar a precisão desse modelo podemos usar o arquivo executável svm-predict na forma a seguir:
#Faz a previsão para um novo conjunto de dados (german)
system("svm-predict german saida resultado.txt")
#Lê os dados preditos de volta para o R
predito<-read.table("resultado.txt")
O comando anterior deve conter três componentes: a base que deseja-se fazer a previsão (validação) aqui denominada german (e deve ter a mesma estrutura da base de treinamento), o arquivo de treinamento (denominado saida) e o arquivo com os valores preditos (aqui denominado resultado.txt). O resultado é apresentado a seguir:

Para outros modelos é necessário executar o mesmo código com variações nos parâmetros e avaliar a acurácia de cada modelo gerado para cada parâmetro selecionado.

segunda-feira, 16 de maio de 2016

Geomarketing com Aprendizado de Máquina.


Geomarketing é um campo interessante de pesquisa que objetiva auxiliar os analistas de marketing em suas decisões através do GIS (Geographic Information Systems).

A proposta desse post é apresentar o mesmo processo de modelagem desenvolvido no trabalhos Mercado de comida japonesa no Distrito Federal : análise das oportunidades de negócio por meio de Geomarketing e Máquinas de Suporte Vetorial.

Basicamente, o processe de modelagem envolve os seguintes passos baseados no trabalho de Silva, C.A (2014) [pág. 70]:


O primeiro passo é obter as variáveis de interesse na mesma unidade observacional da malha digital que será utilizada no Geomarketing:

#Limpa o workspace
rm(list=ls())
### Define o  Working Directory
setwd("C:\\Users\\Dados\\POF 2008")
source("LeBasesPosicaoFixa.R")
### Cria um novo arquivo somente com as informações necessárias
# Seleciona tudo: 
fselpr<-function(x) x
#Seleciona somente UF 53: fselpr <- function(x) x[substring(x,3,4)==53]
rcsel.pfix(file.inp="T_MORADOR_S.txt", file.out="MORADOR.txt",
           first=c(3,5,8,9,11,12,60,112),
           last=c(4,7,8,10,11,13,62,127),
           fselpr)
###Lê os dados do arquivo de interesse
dados<-read.table("MORADOR.txt")
###Deleta o arquivo MORADOR.txt
file.remove("MORADOR.txt")
#Coloca os nomes das variáveis
colnames(dados)<-c("COD_UF","NUM_SEQ","NUM_DV","COD_DOMC","NUM_UC","NUM_INFORMANTE",
                   "IDADE_ANOS","RENDA_BRUTA_MONETARIA")
#Coloca os labels nas variáveis
library(Hmisc)
label(dados$COD_UF)<-'CÓDIGO DA UF'
label(dados$NUM_SEQ)<-'NÚMERO SEQUENCIAL'
label(dados$NUM_DV)<-'DV DO SEQUENCIAL'
label(dados$COD_DOMC)<-'NÚMERO DO DOMICÍLIO'
label(dados$NUM_UC)<-'NÚMERO DA UC'
label(dados$NUM_INFORMANTE)<-'NÚMERO DO INFORMANTE'
label(dados$IDADE_ANOS)<-'IDADE CALCULADA EM ANOS'
label(dados$RENDA_BRUTA_MONETARIA)<-'RENDA MONETÁRIA MENSAL DA UC'
describe(dados)
##Lê os dados do arquivo T_DESPESA_INDIVIDUAL_S.txt
rcsel.pfix(file.inp="T_DESPESA_INDIVIDUAL_S.txt", file.out="DESPESA.txt",
           first=c(3,5,8,9,11,12,44,46,53),
           last=c(4,7,8,10,11,13,45,50,63), fselpr)
###Lê os dados do arquivo de interesse
desp<-read.table("DESPESA.txt")
###Deleta o arquivo DESPESA.txt
file.remove("DESPESA.txt")
#Coloca os nomes das variáveis
colnames(desp)<-c("COD_UF","NUM_SEQ","NUM_DV","COD_DOMC","NUM_UC",
                  "NUM_INF","NUM_QUADRO","COD_ITEM","VAL_DESPESA")
#Coloca os labels nas variáveis
label(desp$COD_UF)<-'CÓDIGO DA UF'
label(desp$NUM_SEQ)<-'NÚMERO SEQUENCIAL'
label(desp$NUM_DV)<-'DV DO SEQUENCIAL'
label(desp$COD_DOMC)<-'NÚMERO DO DOMICÍLIO'
label(desp$NUM_UC)<-'NÚMERO DA UC'
label(desp$NUM_INF)<-'NÚMERO DO INFORMANTE'
label(desp$NUM_QUADRO)<-'NÚMERO DO QUADRO'
label(desp$COD_ITEM)<-'CÓDIGO DO ITEM'
label(desp$VAL_DESPESA)<-'VALOR DA DESPESA / AQUISIÇÃO'
O código anterior utiliza as bases da Pesquisa de Orçamentos Familiares de 2008: T_DESPESA_INDIVIDUAL_S.txt e T_MORADOR_S.txt além da função de leitura LeBasesPosicaoFixa.R. Em seguida, as bases de morador e despesas são unidas através do merge entre os dados:
#Mostrar até 8 casas decimais 
options("scipen" = 8)
##Faz o merge entre as bases
#Renomeia a variável NUM_INFORMANTE
colnames(dados)[6]<-"NUM_INF"
#Faz o merge
tudo<-merge(dados,desp,by=c("COD_UF","NUM_SEQ","NUM_DV","COD_DOMC",
                            "NUM_UC","NUM_INF"),all=TRUE)
#Obtêm a base somente com os itens 101 e 102 do quadro 28
ingresso<-tudo[which(tudo$NUM_QUADRO==28&
                       tudo$COD_ITEM%in%c(101,201)),]
As últimas linhas obtêm somente os registros para o gasto com ingressos para cinema e teatro. Esses valores podem ser consultados na documentação da POF 2008. Como os dados de interesse estão por Setor Censitário ou Área de Ponderação, precisamos estudar quais variáveis já existem nessas bases para padronizar com as variáveis da POF. Para isso, é necessário consultar o documento Descrição das variáveis - Microdados da amostra do Censo. Nesse exercício, vamos trabalhar com as variáveis V6036 – Idade calculada em anos e V5070 - Rendimento familiar per capita em julho de 2010 assim a leitura dos dados é feito de maneira similar:
### Cria um novo arquivo somente com as informações necessárias
# Seleciona tudo: 
fselpr<-function(x) x
rcsel.pfix(file.inp="Amostra_Pessoas_53.txt", file.out="CENSO.txt",
           first=c(8,62,406),
           last=c(20,64,413),
           fselpr)
###Lê os dados do arquivo de interesse
censo<-read.table("CENSO.txt")
###Deleta o arquivo CENSO.txt
file.remove("CENSO.txt")
#Coloca os nomes das variáveis
colnames(censo)<-c("CD_APONDE","IDADE_ANOS","RENDA_BRUTA_MONETARIA")
#Arruma a renda pois tem duas casas decimais
censo$RENDA_BRUTA_MONETARIA<-censo$RENDA_BRUTA_MONETARIA/100
Note que o arquivo Amostra_Pessoas_53.txt pode ser obtido diretamente do sítio do IBGE. Nesse exercício não utilizaremos os pesos amostrais fornecidos para que a abordagem seja a mais simples possível, dessa forma, precisamos obter por Área de Ponderação a idade média e a renda média:
#Remove outliers
censo<-censo[which(censo$RENDA_BRUTA_MONETARIA<999999),]
#Calcula a média da idade e renda por área de ponderação:
library(dplyr)
by_pes <- group_by(censo,CD_APONDE)
geo<-summarise(by_pes, 
               IDADE_ANOS=mean(IDADE_ANOS), 
               RENDA_BRUTA_MONETARIA=mean(RENDA_BRUTA_MONETARIA)
               )
Em seguida, precisamos treinar a Máquina de Suporte Vetorial para que reconheça o padrão de consumo médio nas regiões, para isso fazemos:
#Junta os dads com quem incluisve não gatsou com ingresso
#Faz o merge
pof<-merge(dados,ingresso,
           by=c("COD_UF","NUM_SEQ","NUM_DV","COD_DOMC",
                "NUM_UC","NUM_INF"),all=TRUE)
#Quando VAL_DESPESA==NA então não gastou com ingresso
pof$VAL_DESPESA[is.na(pof$VAL_DESPESA)]<-0
#Treina a máquina
library(kernlab)
svm<-ksvm(VAL_DESPESA~IDADE_ANOS.x+RENDA_BRUTA_MONETARIA.x,data=pof,
          C = 1, epsilon = 0.1,type="eps-svr",kernel="rbfdot",
          kpar=list(sigma=4),cross=3)
Aqui novamente por simplicidade, não faremos uma busca exaustiva nos parâmetros ótimos do SVM para tentar manter a abordagem o mais simples possível. Uma vez treinada a máquina, fazemos a previsão do valor gasto com ingressos na base do CENSO:
#Faz a previsão:
colnames(geo)<-c("CD_APONDE","IDADE_ANOS.x","RENDA_BRUTA_MONETARIA.x")
VAL_DESPESA<-predict(svm,geo)
#Junta com a base do CENSo o valor predito
geo<-cbind(geo,VAL_DESPESA)
Pronto!! Apesar do modelo não ter se ajustado muito bem (pois não procuramos pelos parâmetros ótimos e nem utilizamos o peso amostral para ponderar as estatísticas) podemos agora esboçar o mapa com as previsões de gasto com ingressos:
#Baixa a imagem do mapa
library(ggmap)
library(RgoogleMaps)
CenterOfMap <- geocode("Brasilia, DF")
#Pode usar terrain, toner, satellite
BSB <- get_map(c(lon=CenterOfMap$lon, lat=CenterOfMap$lat),zoom = 12, maptype = "satellite", source = "google")
BSB <- ggmap(BSB)
BSB 
#Abre a malha
library(rgdal)
library(rgeos)
library(ggplot2)
library(plyr)
sfn <- readOGR(".","BRASILIA_area_de_ponderacao") 
#Bounding box 
b <- bbox(sfn)
#Junta o mapa com os dados de previsão
sfn@data$id <- rownames(sfn@data)
sfn@data   <- join(sfn@data, geo, by="CD_APONDE")
#Cria a projeção
sfn <- spTransform(sfn, CRS("+proj=longlat +datum=WGS84"))
#Cria o objeto ggplot
sfn.df <- fortify(sfn)
sfn.df     <- join(sfn.df,sfn@data, by="id")
#Faz o mapa
BSB<-BSB + geom_polygon(data = sfn.df, aes(x = long, y = lat, group = group, fill = VAL_DESPESA), 
                        colour = 'grey',  alpha = .4, size = .1) +
  theme(legend.position = "left", title = element_blank())
BSB


sexta-feira, 15 de abril de 2016

Usando a biblioteca LIBSVM no R.


Máquinas de Suporte Vetorial tem tido um grande apelo nas aplicações práticas. Nesse post, seguiremos a mesma ideia do post anterior mas agora, utilizaremos uma biblioteca já existente escrita em Java para a execução do SVM.

A biblioteca a ser utilizada é denominada LIBSVM. O primeiro passo é obter o código fonte e armazená-lo em alguma pasta na sua máquina. Os arquivos estão na pasta denominada Java.

O primeiro passo é fazer a leitura dos dados de interesse no R. Utilizaremos aqui os dados já apresentados no post acerca do Risco de Crédito.

Algumas etapas são necessárias para se preparar o arquivo para o LIBSVM:

#Limpa o Workspace
rm(list=ls())
#Importa os dados German.csv 
setwd("C:\\Blog\\java")
library(RCurl)
URL <- "https://dl.dropboxusercontent.com/u/36068691/Blog/german.csv"
x <- getURL(URL)
dados <- read.csv(textConnection(x))
#Separa o vetor de resposta
RESPONSE<-dados$RESPONSE
#Troca zero por -1
RESPONSE[RESPONSE==0]<- -1
#Remove a coluna RESPONSE
dados<-dados[,-32]
O formato exigido pelo LIBSVM deve seguir o formato: [categoria] [coluna1]:[valor1] [coluna2]:[valor2] .... Nesse sentido, fazemos:
#Função para formato libSVM
libsvm<-function(x){
  tt<-cbind(t(x),1:length(x))
  tt<-tt[tt[,1]>0,]
  str<-paste(c(rbind(tt[,2],":",tt[,1]," ")),collapse ="")
  return(str)
} 

#Cria as strings
str<-""
for(i in 1:nrow(dados)){
  x<-dados[i,]
  str<-rbind(str,libsvm(x))
}
str<-str[-1,]

#Adiciona a resposta
txt<-cbind(RESPONSE,str)
txt<-apply(txt,1,function(x) paste(x[1],x[2]))
write.table(txt,"C:/Blog/german",quote=F,row.names=F,col.names=F)
O arquivo german gerado já estará no formato do LIBSVM. Observação: A criação do arquivo german no formato esparso também pode ser gerado utilizando-se as funções read.matrix.csr e write.matrix.csr do pacote e1071. É preciso compilar agora o arquivo svm_train.java e gerar o arquivo svm_train.class antes de prosseguir. Pode utilizar o Eclipse para isso. O próximo passo é utilizar a função svm_train da biblioteca LIBSVM:
#Em seguida executamos a função java
parms<-c("-s 0 "," -t 3 "," -d 3 "," -g 1 "," german "," saida")
system(paste("java svm_train",paste(parms,collapse = "")))
Os resultados da análise são apresentados no console:

segunda-feira, 16 de novembro de 2015

All your Bayes are belong to us!


A campanha do Facebook para fortalecer sua equipe de pesquisadores em Aprendizado de Máquina obteve uma grande vitória.

Dia 22/11/2014 o laboratório de Inteligência Artificial do Facebook postou no Facebook, seu mais novo colaborador: Vladimir Vapnik. Ele foi responsável pelo desenvolvimento do que hoje é conhecido como Máquina de Suporte Vetorial.

Já a piadinha geek com o termo "All your Bayes are belong to us!" refere-se a um jogo antigo de Mega-Drive (Zero Wing) que teve uma tradução "quebrada" do japonês para o inglês na forma "All your base are belong to us"!, o base trocado por bayes é uma provocação, sugerindo a superioridade do SVM (Suport Vector Machine) sobre as abordagens bayesianas tradicionais.


Note ainda que no topo do quadro há a seguinte desigualdade:


Esta fórmula representa o limite probabilístico (com probabilidade $1-\eta$) do risco esperado de um classificador sobre a abordagem de Empirical Risk Minimization, base da construção das Máquinas de Suporte Vetorial. Em termos simples, essa desigualdade relaciona o erro populacional do classificador com o erro amostral (empírico) em função de um conjunto de treinamento (amostra) de tamanho $l$ e em que a cardinalidade do conjunto de funções de perda é $N$.

Bem, a foto é basicamente uma declaração sobre a superioridade da teoria da aprendizagem estatística de Vapnik sobre a alternativa bayesiana. Em poucas palavras, o paradigma bayesiano começa com a proposição de uma distribuição a priori ao longo de um conjunto de hipóteses (nossas crenças) e então é atualizada por meio dos dados (distribuição a posteriori). Nesse paradigma, a regra de decisão ótima para um classificador é baseado na distribuição a posteriori.

Já no paradigma de Empirical Risk Minimization não há necessidade de pressupostos a cerca da distribuição de probabilidade dos dados. Isto é motivado pelo fato de que a estimativa de densidade é um problema mal-posto (ill-posed), e, portanto, desejamos evitar esse passo intermediário. O objetivo é minimizar diretamente a probabilidade de se fazer uma má decisão no futuro.

quarta-feira, 15 de abril de 2015

Text Mining com kernels string no R - Parte 3.


Nesse post daremos continuidade ao que já vimos em posts anteriores como Text Mining com kernels string no R - Parte 1 e Text Mining com kernels string no R - Parte 2. Nessa etapa, vamos tentar reconhecer o padrão das informações prestadas pela Petrobras de 2006 até o primeiro trimestre 2014, para isso, considere os seguintes pacotes:

#Habilita as bibliotecas necessárias
library(tm)
library(wordcloud)
library(Rstem)

Vamos trabalhar com os textos informados pela Petrobras, os quais podem ser obtidos nesse link. Salve esses arquivos em alguma pasta do seu computador, como por exemplo, C:\Text Mining. Em seguida, precisamos transformar os arquivos em PDF para o formato TXT, o qual é possível de ser lido pelo R:

#Seleciona o arquivo de texto a ser minerado
dest<- "C:\\Text Mining\\2006 - 1T.pdf"

#Executa o programa que converte pdf em txt
exe<-"C:\\Program Files\\xpdfbin-win-3.03\\bin64\\pdftotext.exe"
system(paste("\"", exe, "\" \"", dest,"\"", sep= ""), wait= F)

#Cria o arquivo no formato txt
filetxt<- sub(".pdf", ".txt", dest)

#Lê os dados do arquivo
txt<- readLines(filetxt, warn=FALSE)

#Deixa tudo minúsculo
txt<- tolower(txt)

#Remove algumas expressões regulares
txt<-removeWords(txt, c("\\f", stopwords("portuguese")))

#Cria os objetos no formato corpus
corpus<-Corpus(VectorSource(txt))

#Remove a pontuação
corpus<-tm_map(corpus,removePunctuation)

#Remove os números
corpus<-tm_map(corpus,removeNumbers)
Note que o código acima só é possível de ser executado se você tiver instalado o arquivo que converte PDF para TXT, qual seja, Xpdf. Na linha número 5 deve estar o endereço do arquivo executável pdftotext.exe o qual é obtido ao se instalar o programa Xpdf. Cada texto em PDF no arquivo é transformado em TXT e pode ser lido. Para cada texto, podemos associar um retorno obtido no trimestre após a divulgação da informação, por exemplo, para o primeiro trimestre de 2006 temos:
#Coloca os textos na forma de Matriz
tdm<- TermDocumentMatrix(corpus)
m<- as.matrix(tdm)

#Cria um data.frame com a frequência das palavras
d<- data.frame(freq= sort(rowSums(m), decreasing =TRUE))

#Coloca as palavras nas colunas
d$word <- row.names(d)
d$stem<- wordStem(d$word, language="portuguese")

#Remove as palavras muito grandes
d<- d[nchar(row.names(d))<20,]

#Agrega as frequências das palavras
agg_freq<- aggregate(freq ~stem, data = d, sum)
agg_word<- aggregate(word ~stem, data =d, function(x) x[1])

#Une os dados de frequência e palavras
d<- cbind(freq = agg_freq[,2], agg_word)

#Ordena as palavras pela frequência
d<- d[order(d$freq,decreasing =TRUE),]

#1 Trimestre 2006
d$Trimestre<-"1t2006"
d$Retorno<-0.03789927 #Retorno do 2t2006
Uma vez criado um DataFrame para cada texto com o seu respectivo retorno trimestral, podemos usar as frequências das palavras como uma covariável na previsão do retorno trimestral. Essa proposta não é nova e tem sido usada em finanças na busca por padrões. Um bom texto para se começar a estudar esse assunto é o artigo Text mining for market prediction: A systematic review.

segunda-feira, 15 de dezembro de 2014

Text Mining com kernels string no R - Parte 1.


A Mineração de texto (Text Mining), também denominada de extração de dados de textuais, ou ainda, análise de textual, refere-se ao processo de obter informação quantitativa a partir de um determinado texto.

Essas informações normalmente são obtidas por meio do reconhecimento de padrões e tendências através de aprendizagem estatística. A Mineração de Texto geralmente envolve o processo de estruturação do texto de entrada, reconhecimento dos padrões de dados estruturados, e, finalmente, a avaliação e interpretação dos resultados.

Nesse post mostraremos como realizar algumas das principais tarefas de Text Mining, as quais são úteis no estudo das mídias sociais com propósitos estratégicos gerenciais e de aplicações em marketing.

Análise textual descritiva: Wordcloud.


Uma nuvem de palavras ou Wordcloud é uma representação visual de dados de texto, normalmente usada para descrever os metadados de palavras-chave em textos específicos. Em geral é representada por palavras isoladas, e a importância de cada palavra é mostrada com um tamanho da fonte ou cor. Neste formato é fácil perceber rapidamente os termos mais proeminentes e sua importância relativa.

Considere por exemplo o Soneto da Felicidade:

#Guarda o texto a ser analisado no objeto "soneto"
soneto<-"A Felicidade

Tristeza não tem fim
Felicidade sim

A felicidade é como a pluma
Que o vento vai levando pelo ar
Voa tão leve
Mas tem a vida breve
Precisa que haja vento sem parar

A felicidade do pobre parece
A grande ilusão do carnaval
A gente trabalha o ano inteiro
Por um momento de sonho
Pra fazer a fantasia
De rei ou de pirata ou jardineira
Pra tudo se acabar na quarta-feira

Tristeza não tem fim
Felicidade sim

A felicidade é como a gota
De orvalho numa pétala de flor
Brilha tranqüila
Depois de leve oscila
E cai como uma lágrima de amor

A felicidade é uma coisa boa
E tão delicada também
Tem flores e amores
De todas as cores
Tem ninhos de passarinhos
Tudo de bom ela tem
E é por ela ser assim tão delicada
Que eu trato dela sempre muito bem

Tristeza não tem fim
Felicidade sim

A minha felicidade está sonhando
Nos olhos da minha namorada
É como esta noite, passando, passando
Em busca da madrugada
Falem baixo, por favor
Pra que ela acorde alegre com o dia
Oferecendo beijos de amor"
Uma vez armazenado o texto de interesse, podemos construir a Wordcloud da seguinte forma:
#Habilita as bibliotecas necessárias
library(tm)           #Text Mining
library(wordcloud)    #Wordcloud
Uma vez habilitadas as bibliotecas tm e wordcloud, é necessário transformar o texto em um objeto próprio para análise:
#Transforma os dados de texto em vetores
vs <- VectorSource(soneto)

#Coloca no formato de Corpus do pacote tm
temp<- Corpus(vs)

#Faz o Word Cloud
wordcloud(temp)
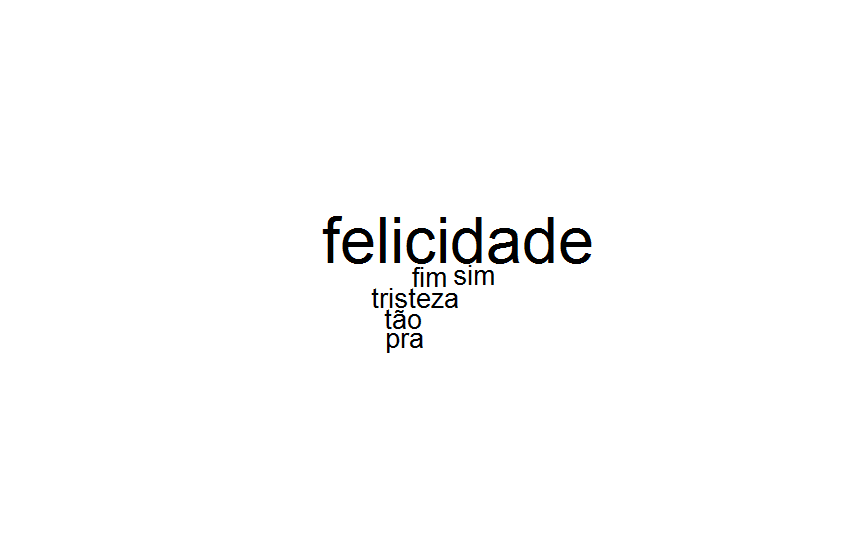
O qual fornece a seguinte Wordcloud:
Podemos melhorar a Wordcloud retirando as preposições e artigos desnecessários, tais como: "por", "de", "pelo", "a", etc. Essa etapa consiste em criar um objeto do tipo Corpus para o qual:
  • Converte todas as palavras para minúsculo.
  • Expande todas as contrações de palavra, por exemplo, "pelo" vira "per o".
  • Remove as palavras "ruído".
  • Remove as pontuações.
#Coloca tudo em minúsculo
wc_corpus <- tm_map(temp, tolower)

#Tira a pountuação e palavras ruído
wc_corpus <- tm_map(wc_corpus, removePunctuation)
wc_corpus <- tm_map(wc_corpus, removeWords, stopwords('portuguese'))

#Cria a frequência de palavras
td_mtx <- TermDocumentMatrix(wc_corpus, control = list(minWordLength = 3))
v <- sort(rowSums(as.matrix(td_mtx)), decreasing=TRUE)
df <- data.frame(word=names(v), freq=v)
wordcloud(df$word, df$freq, min.freq=3)
Obtendo assim:
Para deixar mais interessante a Wordcloud fazemos:
#Habilitando o pacote de cores
library(RColorBrewer)
pal2 <- brewer.pal(8,"Dark2")

#Gera o word cloud
wordcloud(df$word, df$freq, min.freq=1,
          max.words=Inf, random.order=FALSE, 
          rot.per=.15, colors=pal2)