SAUDAÇÕES!

Seja bem vindo à página do professor Pedro Albuquerque. Para saber mais sobre meu currículo, disciplinas ministradas e interesses de pesquisa, navegue no menu disponível no topo da página.
Mostrando postagens com marcador Text Mining. Mostrar todas as postagens

quarta-feira, 15 de abril de 2015

Text Mining com kernels string no R - Parte 3.


Nesse post daremos continuidade ao que já vimos em posts anteriores como Text Mining com kernels string no R - Parte 1 e Text Mining com kernels string no R - Parte 2. Nessa etapa, vamos tentar reconhecer o padrão das informações prestadas pela Petrobras de 2006 até o primeiro trimestre 2014, para isso, considere os seguintes pacotes:

#Habilita as bibliotecas necessárias
library(tm)
library(wordcloud)
library(Rstem)

Vamos trabalhar com os textos informados pela Petrobras, os quais podem ser obtidos nesse link. Salve esses arquivos em alguma pasta do seu computador, como por exemplo, C:\Text Mining. Em seguida, precisamos transformar os arquivos em PDF para o formato TXT, o qual é possível de ser lido pelo R:

#Seleciona o arquivo de texto a ser minerado
dest<- "C:\\Text Mining\\2006 - 1T.pdf"

#Executa o programa que converte pdf em txt
exe<-"C:\\Program Files\\xpdfbin-win-3.03\\bin64\\pdftotext.exe"
system(paste("\"", exe, "\" \"", dest,"\"", sep= ""), wait= F)

#Cria o arquivo no formato txt
filetxt<- sub(".pdf", ".txt", dest)

#Lê os dados do arquivo
txt<- readLines(filetxt, warn=FALSE)

#Deixa tudo minúsculo
txt<- tolower(txt)

#Remove algumas expressões regulares
txt<-removeWords(txt, c("\\f", stopwords("portuguese")))

#Cria os objetos no formato corpus
corpus<-Corpus(VectorSource(txt))

#Remove a pontuação
corpus<-tm_map(corpus,removePunctuation)

#Remove os números
corpus<-tm_map(corpus,removeNumbers)
Note que o código acima só é possível de ser executado se você tiver instalado o arquivo que converte PDF para TXT, qual seja, Xpdf. Na linha número 5 deve estar o endereço do arquivo executável pdftotext.exe o qual é obtido ao se instalar o programa Xpdf. Cada texto em PDF no arquivo é transformado em TXT e pode ser lido. Para cada texto, podemos associar um retorno obtido no trimestre após a divulgação da informação, por exemplo, para o primeiro trimestre de 2006 temos:
#Coloca os textos na forma de Matriz
tdm<- TermDocumentMatrix(corpus)
m<- as.matrix(tdm)

#Cria um data.frame com a frequência das palavras
d<- data.frame(freq= sort(rowSums(m), decreasing =TRUE))

#Coloca as palavras nas colunas
d$word <- row.names(d)
d$stem<- wordStem(d$word, language="portuguese")

#Remove as palavras muito grandes
d<- d[nchar(row.names(d))<20,]

#Agrega as frequências das palavras
agg_freq<- aggregate(freq ~stem, data = d, sum)
agg_word<- aggregate(word ~stem, data =d, function(x) x[1])

#Une os dados de frequência e palavras
d<- cbind(freq = agg_freq[,2], agg_word)

#Ordena as palavras pela frequência
d<- d[order(d$freq,decreasing =TRUE),]

#1 Trimestre 2006
d$Trimestre<-"1t2006"
d$Retorno<-0.03789927 #Retorno do 2t2006
Uma vez criado um DataFrame para cada texto com o seu respectivo retorno trimestral, podemos usar as frequências das palavras como uma covariável na previsão do retorno trimestral. Essa proposta não é nova e tem sido usada em finanças na busca por padrões. Um bom texto para se começar a estudar esse assunto é o artigo Text mining for market prediction: A systematic review.

segunda-feira, 16 de março de 2015

Text Mining com kernels string no R - Parte 2.


Inicialmente vimos no post Text Mining com kernels string no R - Parte 1 como gerar Wordclouds as quais são úteis na análise descritiva de informação textual, entretanto, podemos fazer algo mais complexo do que simplesmente uma análise descritiva. Podemos reconhecer padrões associados aos textos.

Considere uma lista de 40 textos obtidos da reuters e armazenados no pacote kernlab:

#Habilita o pacote kernlab
library(kernalb)

#Base de notícias da reuters
data(reuters)

#Armazena as palavras chave
y <- rlabels

#Armazena os textos
x <- reuters
Em seguida podemos fazer um Kernel Principal Component Analysis para estudar o padrão das palavras chave:
#Cria o Kernel String
sk <- stringdot(type="spectrum", length=2, normalized=TRUE)

#Faz o Kernel Principal Component Analysis com base nos textos
kpc <- kpca(x,kernel=sk,scale=c())

#Plota o Kernel Principal Component Analysis
plot(rotated(kpc),col=ifelse(y==levels(y)[1],1,2))
Obtendo assim:
O Kernel Principal Component Analysis é uma boa ferramenta para estudar os "tipos" de textos existentes, por exemplo, podemos encontrar textos mais "otimistas", "pessimistas" e atribuir a esses textos um valor quantitativo que pode ser utilizado nos campos de marketing e finanças.

segunda-feira, 15 de dezembro de 2014

Text Mining com kernels string no R - Parte 1.


A Mineração de texto (Text Mining), também denominada de extração de dados de textuais, ou ainda, análise de textual, refere-se ao processo de obter informação quantitativa a partir de um determinado texto.

Essas informações normalmente são obtidas por meio do reconhecimento de padrões e tendências através de aprendizagem estatística. A Mineração de Texto geralmente envolve o processo de estruturação do texto de entrada, reconhecimento dos padrões de dados estruturados, e, finalmente, a avaliação e interpretação dos resultados.

Nesse post mostraremos como realizar algumas das principais tarefas de Text Mining, as quais são úteis no estudo das mídias sociais com propósitos estratégicos gerenciais e de aplicações em marketing.

Análise textual descritiva: Wordcloud.


Uma nuvem de palavras ou Wordcloud é uma representação visual de dados de texto, normalmente usada para descrever os metadados de palavras-chave em textos específicos. Em geral é representada por palavras isoladas, e a importância de cada palavra é mostrada com um tamanho da fonte ou cor. Neste formato é fácil perceber rapidamente os termos mais proeminentes e sua importância relativa.

Considere por exemplo o Soneto da Felicidade:

#Guarda o texto a ser analisado no objeto "soneto"
soneto<-"A Felicidade

Tristeza não tem fim
Felicidade sim

A felicidade é como a pluma
Que o vento vai levando pelo ar
Voa tão leve
Mas tem a vida breve
Precisa que haja vento sem parar

A felicidade do pobre parece
A grande ilusão do carnaval
A gente trabalha o ano inteiro
Por um momento de sonho
Pra fazer a fantasia
De rei ou de pirata ou jardineira
Pra tudo se acabar na quarta-feira

Tristeza não tem fim
Felicidade sim

A felicidade é como a gota
De orvalho numa pétala de flor
Brilha tranqüila
Depois de leve oscila
E cai como uma lágrima de amor

A felicidade é uma coisa boa
E tão delicada também
Tem flores e amores
De todas as cores
Tem ninhos de passarinhos
Tudo de bom ela tem
E é por ela ser assim tão delicada
Que eu trato dela sempre muito bem

Tristeza não tem fim
Felicidade sim

A minha felicidade está sonhando
Nos olhos da minha namorada
É como esta noite, passando, passando
Em busca da madrugada
Falem baixo, por favor
Pra que ela acorde alegre com o dia
Oferecendo beijos de amor"
Uma vez armazenado o texto de interesse, podemos construir a Wordcloud da seguinte forma:
#Habilita as bibliotecas necessárias
library(tm)           #Text Mining
library(wordcloud)    #Wordcloud
Uma vez habilitadas as bibliotecas tm e wordcloud, é necessário transformar o texto em um objeto próprio para análise:
#Transforma os dados de texto em vetores
vs <- VectorSource(soneto)

#Coloca no formato de Corpus do pacote tm
temp<- Corpus(vs)

#Faz o Word Cloud
wordcloud(temp)
O qual fornece a seguinte Wordcloud:
Podemos melhorar a Wordcloud retirando as preposições e artigos desnecessários, tais como: "por", "de", "pelo", "a", etc. Essa etapa consiste em criar um objeto do tipo Corpus para o qual:
  • Converte todas as palavras para minúsculo.
  • Expande todas as contrações de palavra, por exemplo, "pelo" vira "per o".
  • Remove as palavras "ruído".
  • Remove as pontuações.
#Coloca tudo em minúsculo
wc_corpus <- tm_map(temp, tolower)

#Tira a pountuação e palavras ruído
wc_corpus <- tm_map(wc_corpus, removePunctuation)
wc_corpus <- tm_map(wc_corpus, removeWords, stopwords('portuguese'))

#Cria a frequência de palavras
td_mtx <- TermDocumentMatrix(wc_corpus, control = list(minWordLength = 3))
v <- sort(rowSums(as.matrix(td_mtx)), decreasing=TRUE)
df <- data.frame(word=names(v), freq=v)
wordcloud(df$word, df$freq, min.freq=3)
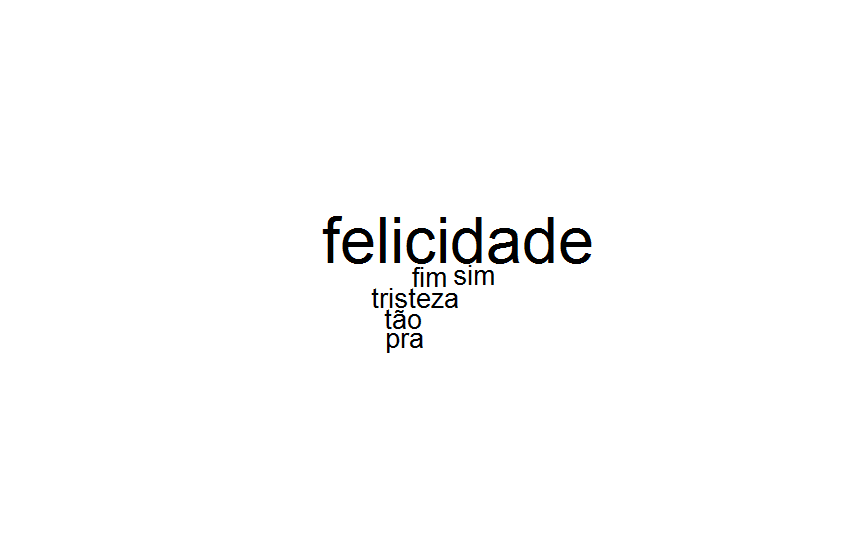
Obtendo assim:
Para deixar mais interessante a Wordcloud fazemos:
#Habilitando o pacote de cores
library(RColorBrewer)
pal2 <- brewer.pal(8,"Dark2")

#Gera o word cloud
wordcloud(df$word, df$freq, min.freq=1,
          max.words=Inf, random.order=FALSE, 
          rot.per=.15, colors=pal2)