SAUDAÇÕES!

Seja bem vindo à página do professor Pedro Albuquerque. Para saber mais sobre meu currículo, disciplinas ministradas e interesses de pesquisa, navegue no menu disponível no topo da página.

sexta-feira, 14 de novembro de 2014

Revolution R - Parte 1.


Hoje uma grande queixa em relação ao uso do R é a dificuldade de lidar com grandes bases de dados (Big Data), nesse sentido, o software Revolution R tem apresentado bons resultados, pois além de lidar com grandes bases de dados utiliza a sintaxe do R para a execução de comandos.

Revolution Analytics é uma empresa de software estatístico focada no desenvolvimento de versões "open-core" do software livre e open source para R. Revolution Analytics foi fundada em 2007 oferecendo apoio e serviços para o software R em um modelo semelhante a abordagem da Red Hat com Linux na década de 1990.

Um bom ponto de partida para entender o Revolution R é pesquisando nos fóruns: http://forums.revolutionanalytics.com/forums/forum.php.

Em 2009, a empresa recebeu nove milhões em capital da Intel, juntamente com uma empresa nomeando Norman H. Nie como seu novo CEO. Em 2010, a empresa anunciou a mudança de nome, bem como uma mudança de foco. Seu principal produto, Revolution R, seria oferecido gratuitamente aos usuários acadêmicos e seu software comercial iria incidir sobre grandes volumes de dados, utilizando multiprocessamento em larga escala e funcionalidade multi-core.

Formato XDF é o formato padrão no Revolution R.


Esse tipo de formato tem como principais características:

  • Armazena dados em blocos para a leitura eficiente de colunas arbitrárias e linhas contíguas.
  • Contém metadados associados, tais como nomes de variáveis​​, descrições e tipos de armazenamento de dados.
  • Suporta um conjunto mais rico de tipos de armazenamento de dados do que R (oito tipos de inteiros, dois tipos de números de ponto flutuante.
  • Escreve blocos de dados de linhas para que o processamento de dados possa ser otimizado.
  • Processa os dados em blocos (grupos de blocos).
  • Otimiza o tamanho dos blocos dependendo da largura de banda do computador individual para I/O.

Uma vez instalado o Revolution R o primeiro passo é criar um projeto:


O interessante é que no Revolution R podemos criar Soluções, Projetos e Scripts. Uma SOLUÇÃO pode conter mais de um PROJETO, e os projetos podem conter um ou mais SCRIPTS. A principal tela do Revolution R é a seguinte:


Suponha que desejamos importar o arquivo Pobreza.csv. Para importar os dados no ambiente Revolution R, basta inserirmos os Snippets. Clique com o botão direito do mouse na tela de Script e escolha:


Em seguida vá na Opção Data Sets:


Escolha a opção Import Data:


Automaticamente, o Revolution R cria a sintaxe básica para importação de dados. Para navegar entre os argumentos da função basta usar a tecla Tab:


Para executar o comando, basta fazer:


Observação: É importante indicar o endereço exato do arquivo Pobreza.csv, como por exemplo:

#Importação dos dados
pobreza.df<-read.table("C:/Pasta/Pobreza.csv",sep=",")

domingo, 13 de janeiro de 2013

Otimização de portfólio por meio do Random Matrix Theory.


A Teoria de Matrizes Aleatórias (Random Matrix Theory - RMT) pode ser utilizada em finanças com o intuito de "filtrar" o ruído presente nas estimativas das estatísticas de interesse como covariâncias e correlações. Essa abordagem tem se mostrado superior a otimização clássica de portifólios como sugerido por Daly, Crane e Ruskin (2007).

Teoria de Matrizes Aleatórias foi inicialmente desenvolvido por Dyson (1962) com o intuito de explicar os níveis de energia de núcleos complexos e tem sido amplamente utilizada no filtro do "ruído" presente em séries temporais financeiras, especialmente em sistemas de grandes dimensões como os mercados de ações.

A ideia é que uma vez que o número de observações e variabilidade são altas nos dados financeiros, as estimativas produzidas para a matriz de variâncias e covariâncias entre os retornos financeiros dos ativos está permeada de ruído e assim, o "verdadeiro" parâmetro pode estar mascarado, fornecendo portfólios sub-ótimos.

Assuma que as matrizes de correlação de variâncias e covariância podem ser expressas da seguinte forma:

$\mathbf{R}=\frac{1}{T}\mathbf{A}\mathbf{A}^{'}$

onde $A$ é uma matriz cujos elementos são independentes e identicamente distribuídos segundo uma $N(0,\sigma^{2})$, então Sengupta e Mitra (1999) mostraram que quando $N\rightarrow\infty$ e $T\rightarrow\infty$ tal que $Q=T/N\geq 1$ é fixado então a distribuição dos autovalores de $\mathbf{R}$ é dada por:

$P(\lambda)=\frac{Q}{2\pi\sigma^{2}}\frac{\sqrt{(\lambda_{+}-\lambda)(\lambda-\lambda_{-})}}{\lambda}$ se $\lambda_{-}\le\lambda\le\lambda_{+}$

onde $\sigma^{2}$ é a variância dos elementos de $\mathbf{A}$ e $\lambda_{\pm}=\sigma^{2}(1+1/Q \pm \sqrt{1/Q})$.

Nesse caso, as matrizes de dados históricos podem ser comparadas com as gerados a partir de retornos aleatórios. Então, somente os autovalores maiores ou iguais a $\lambda_{+}$ conteriam "informação" sobre o Mercado.

Considere os dados:

#Limpa o Workspace
rm(list=ls())

#Habilita o pacote quantmod
library(quantmod)

#Início do período de interesse
inicio = as.Date("2011-01-01") 

#Fim do período de interesse
fim = as.Date("2012-12-31") 

#Ativos
ativos<-c("AMBV4.SA","BBAS3.SA","BBDC4.SA","BISA3.SA","BRFS3.SA","BRKM5.SA","BTOW3.SA","BVMF3.SA","CESP6.SA","CIEL3.SA","CMIG4.SA","CPLE6.SA","CRUZ3.SA","CSAN3.SA","CSNA3.SA","CYRE3.SA","ELET3.SA","ELET6.SA","ELPL4.SA","EMBR3.SA","LIGT3.SA","LREN3.SA","MRFG3.SA","NATU3.SA","PCAR4.SA","PDGR3.SA","PETR3.SA","PETR4.SA","RDCD3.SA","RSID3.SA","SANB11.SA","TIMP3.SA","TRPL4.SA","UGPA3.SA","USIM3.SA","USIM5.SA","VALE3.SA","VALE5.SA")

#Força downloads no Yahoo Finance.
getSymbolsCont <- 
  function(tickers, from=NULL, to=Sys.Date(), src="yahoo") { 
    ok = FALSE 
    n = length(tickers) 
    i = 1 
    while(i <= n | !ok) { 
      
      print(tickers[i]) 
      
      sym = NULL 
      try ( sym <- getSymbols(tickers[i], from=from, to=to, src=src, 
                              auto.assign=FALSE)) 
      
      if(!is.null(sym)) { 
        assign(tickers[i], sym, envir = .GlobalEnv) 
        i = i+1 
        ok=TRUE 
      } else {ok=FALSE} 
      
      Sys.sleep(1) 
    } 
  } 

#Obtêm os dados
series.env <- new.env() 
getSymbolsCont(ativos, src="yahoo",from=inicio,to=fim)

#Une os dados
dados <- merge(AMBV4.SA,BBAS3.SA,BBDC4.SA,BISA3.SA,BRFS3.SA,BRKM5.SA,BTOW3.SA,BVMF3.SA,CESP6.SA,CIEL3.SA,CMIG4.SA,CPLE6.SA,CRUZ3.SA,CSAN3.SA,CSNA3.SA,CYRE3.SA,ELET3.SA,ELET6.SA,ELPL4.SA,EMBR3.SA,LIGT3.SA,LREN3.SA,MRFG3.SA,NATU3.SA,PCAR4.SA,PDGR3.SA,PETR3.SA,PETR4.SA,RDCD3.SA,RSID3.SA,SANB11.SA,TIMP3.SA,TRPL4.SA,UGPA3.SA,USIM3.SA,USIM5.SA,VALE3.SA,VALE5.SA)

#Dados Closing Price
dados.Cl<-Cl(dados)

#Calcula o log-retorno
dados.Cl<-na.omit(apply(dados.Cl,2,function(x)  diff(log(x))))
head(dados.Cl)
O próximo passo é construir a matriz de variâncias e covariância para os dados:
#Matriz de variâncias e covariâncias
R<-nrow(dados.Cl)*as.matrix(cov(dados.Cl))
Em seguida precisamos calcular $\lambda_{+}=\sigma^{2}(1+1/Q + \sqrt{1/Q})$:
#Lambda máximo
A<-as.numeric(chol(R))
A<-A[which(A>0)]
sigma2<-var(A)
Q<-nrow(dados.Cl)/ncol(dados.Cl)
lambda.p<-sigma2*(1+1/Q + sqrt(1/Q))
Nesse caso, fica evidente que há autovalores que são "ruídos" e autovalores "informativos". Laloux et. al. (2000) sugerem a seguinte abordagem: 1 - Calcule a matriz diagonal de autovalores da matriz de variâncias e covariâncias usando decomposição espectral. Nessa primeira etapa, a matriz de variâncias e covariâncias $\mathbf{V}$ pode ser escrita como $\mathbf{V}=\mathbf{E}\mathbf{\Lambda} \mathbf{E}^{-1}$, no R podemos fazer:
#Decomposição espectral
r <- eigen(R)
E <- r[[2]]
Lambda <- diag(r[[1]])
hist(r[[1]])
abline(v=lambda.p,col=3,lty=3)
which(r[[1]] < lambda.p)
2 - Na matriz $\mathbf{\Lambda}$ substitua os autovalores "ruído", ou seja, aqueles que são inferiores a $\lambda_{+}$ pela média de todos os autovalores "ruído" e mantenha os autovalores "informativos" os mesmos. Realizando essa etapa no R temos:
#Lambda Ruídos
iLambdas<-which(r[[1]] < lambda.p)
lambda.medio<-mean(r[[1]][iLambdas])
lambda.filtered<-r[[1]]
lambda.filtered[iLambdas]<-lambda.medio
Lambda.filtered<-diag(lambda.filtered)
3 - A matriz $\mathbf{\Lambda}_{filtrado}$ obtida no passo anterior é combinada novamente por meio da decomposição espectral na forma $\mathbf{V}_{filtrado}=\mathbf{E}\mathbf{\Lambda}_{filtrado} \mathbf{E}^{-1}$. Note que nessa abordagem o traço da matriz $\mathbf{V}_{filtrado}$ é igual a $\mathbf{V}$.
#Encontra a matriz de variâncias e covariâncias filtrada
R.filtered<-E%*%Lambda.filtered%*%solve(E)
4 - Constrói-se as carteiras usando então a matriz $\mathbf{V}_{filtrado}$. Nesse caso desejamos obter os pesos: $w_{i}=\frac{\displaystyle\sum_{j=1}^{n}\sigma_{ij}^{-1}}{\displaystyle\sum_{j,k}\sigma_{jk}^{-1}}$ que minimizam $\mbox{Min }W = \displaystyle\sum_{i,j}w_{i}w_{j}\sigma_{ij}$ onde $\sum_{i=1}^{n}w_{i}=1$ e $\mathbf{V}_{filtrado}^{-1}=\{\sigma_{ij}^{-1}\}$.
#Pesos para os ativos
R.inv<-solve(R.filtered)
pesos<-apply(R.inv,1,function(x)sum(x)/sum(R.inv))
pesos<-cbind(pesos,colnames(dados.Cl))

Abordagem de Plerou.

Plerou et. al. (2002) sugerem ao invés de substituir pela média os autovalores "ruído", substituir simplesmente por zero, e após obter a matriz filtrada na forma: $\mathbf{V}_{filtrado}=\mathbf{E}\mathbf{\Lambda}_{filtrado} \mathbf{E}^{-1}$

Corrigir a diagonal de $\mathbf{V}_{filtrado}$ na forma: $\mbox{diag}(\mathbf{V}_{filtrado})=\mbox{diag}(\mathbf{V})$

sábado, 5 de janeiro de 2013

Redes neurais no R: Aplicações em finanças.


Uma rede neural artificial, muitas vezes chamada apenas de rede neural, é um modelo matemático inspirado pelas redes neurais biológicas.

Uma rede neural consiste em um grupo de neurônios artificiais interligados e processa a informação através de uma abordagem conexionista à computação. Na maioria dos casos, uma rede neural é um sistema adaptável, que muda a sua estrutura durante uma fase de aprendizagem.

As redes neurais são usadas para modelar relações complexas entre entradas e saídas ou para encontrar padrões em dados.

Considere, por exemplo, a órbita dos planetas em torno do sol ou o calendário das mares.

A ideia central do aprendizado de máquina é:

"Pode-se usar o computador para descobrir e descrever padrões baseados em dados ?"

De maneira formal, a hipótese básica do aprendizado de máquina é a Hipótese de Aprendizagem Indutiva:

Uma função adequada encontrada para modelar a função alvo para um conjunto suficientemente grande de dados também irá funcionar para modelar adequadamente exemplos não observados.

Isso quer dizer que se encontrarmos alguma "boa fórmula" para o movimento dos planetas em torno do sol, por exemplo, e que essa fórmula tenha sido construída com base em uma amostra suficientemente grande, espera-se que essa "boa fórmula" funcione bem "out-of-sample".

Nesse post mostrarei como usar o pacote neuralnet com uma aplicação a finanças.

Pacote neuralnet.

O pacote neuralnet foi construído de forma a ser possível trabalhar com Perceptron Multi-camadas (multi-layer perceptrons) no contexto da análise de regressão, isto é, para aproximar as relações funcionais entre variáveis independentes e variáveis resposta.

Assim, as redes neurais podem ser utilizadas como extensões do modelo linear generalizado.

Uma das vantagens do pacote neuralnet é a possibilidade de poder se trabalhar com um número arbitrário de covariáveis e​​ também de variáveis ​​de resposta, assim como o número de camadas ocultas.

Redes neurais.

Em muitas situações, a relação funcional entre as covariáveis ​​(também conhecidas como variáveis ​​de entrada ou variáveis independentes) e as variáveis ​​de resposta (também conhecidas como variáveis ​​de saída ou variáveis dependentes) é de grande interesse.

As redes neurais artificiais podem ser aplicadas como aproximação a qualquer relação funcional complexa.

Ao contrário dos modelos lineares generalizados (McCullagh e Nelder, 1989), não é necessário que o tipo de relação entre variáveis ​​dependentes e variáveis ​​resposta seja, por exemplo, uma combinação linear.

Isso faz das redes neurais artificiais uma valiosa ferramenta quantitativa. Esses modelos são, particularmente, extensões diretas dos modelos lineares generalizados e podem ser aplicados de maneira semelhante.

Dados observados são usados ​​para treinar a rede neural, fazendo assim com que a rede neural "aprenda" uma aproximação da relação entre as variáveis independentes e dependentes de forma iterativa por meio da adaptação contínua dos seus parâmetros. De fato, usando a nomenclatura estatística, os parâmetros do modelo são estimados por meio da amostra.

Perceptron Multi-Camadas.

O pacote neuralnet se concentra nos modelos Perceptron Multi-Camadas (Multi-Layer Perceptrons (MLP))(Bishop, 1995), os quais são úteis na modelagem por meio de relações funcionais entre as variáveis.

A estrutura subjacente de um MLP é um grafo orientado, isto é, consiste de vértices (neurônios) e arestas (sinapses).

Os neurônios são organizados em camadas, que são normalmente ligadas por sinapses. No pacote neuralnet, uma sinapse só pode se conectar a camadas posteriores.

A camada de entrada é constituída por todas as covariáveis (um neurônio para cada covariável) separadas por neurônios (camadas ocultas) até as variáveis ​​resposta.

Essas camadas intermédias são denominadas camadas ocultas (ou variáveis latentes), por não serem diretamente observáveis​​.

As camadas de entrada e as camadas ocultas incluem um neurônio constante, o qual estará associado ao intercepto em modelos lineares, ou seja, não é diretamente influenciado por qualquer covariável.


A figura anterior retirada de Günther e Fritsch (2010) representa um exemplo de uma rede neural com dois neurônios de entrada (A e B) e um neurônio de saída (Y), além de uma camada oculta composta de três neurônios.

Um peso (parâmetro) está associado a cada uma das sinapses, representando o efeito correspondente do neurônio e de todos os dados passam pela rede neural como sinais.

Os sinais são processados ​​inicialmente pela função de integração combinando todos os sinais de entrada e, em seguida, pela função de ativação transformando os resultados do neurônio.

O modelo perceptron multicamada mais simples consiste de uma única camada de entrada com $n$ covariáveis ​e uma camada de saída com um único neurônio de saída. Esse modelo calcula a seguinte função:


onde $w_{0}$ denota o intercepto, $\mathbf{w} = (w_{1},\dots, w_{n})$ o vetor de todos os demais pesos (parâmetros), e $\mathbf{x} = (x_{1},\dots, x_{n})$ o vetor de todas as covariáveis.

A função é matematicamente equivalente à estrutura padrão do modelo linear generalizado com função de ligação $f^{-1}(.)$. Portanto, todos os pesos calculados são, neste caso, equivalentes aos parâmetros da regressão via MLG.

Para aumentar a flexibilidade da modelagem mais camadas ocultas podem ser incluídas, aumentando assim a "não-linearidade" do modelo. No entanto, Hornik et al. (1989) mostraram que uma única camada oculta é suficiente para modelar qualquer função contínua por partes.

O modelo perceptron multicamada com uma camada oculta consistindo de $J$ neurônios calcula a seguinte função:


onde $w_{0}$ denota o intercepto do neurônio de saída e $w_{0j}$ representa o intercepto do $j$-ésimo neurônio oculto. Além disso, $w_{j}$ denota o peso sináptico correspondente à sinapse começando no $j$-ésimo neurônio oculto e que conduz ao neurônio de saída. $\mathbf{w_{j}} = (w_{1j},\dots, w_{nj})$ o vetor de todos os pesos sinápticos correspondentes às sinapses que conduzem ao $j$-ésimo neurônio oculto, e $\mathbf{x} = (x_{1},\dots, x_{n})$ é o vetor de todas as covariáveis.

Apesar das redes neurais serem extensões diretas dos MLG, os parâmetros não podem ser interpretados da mesma maneira.

De maneira formal, todos os neurônios ocultos e os neurônios de saída calculam a seguinte função: $f(g(z_{0},z_{1},\dots, z_{k})) = f(g(\mathbf{z}))$ a partir das saídas de todos os neurônios precedentes $z_{0}, z_{1},\dots, z_{k}$, onde $g:\mathbb{R}^{k+1}\rightarrow \mathbb{R}$ representa a função de integração e $f:\mathbb{R}\rightarrow \mathbb{R}$ é a função de ativação. O neurônio unitário $z_{0}$ é uma constante o qual está relacionado com o conceito de intercepto em modelos de regressão.

A função de integração é, muitas vezes, definida como $g(\mathbf{z})= w_{0}z_{0} + \sum_{i=1}^{n}w_{i}z_{i}= w0 + \mathbf{w}^{'}\mathbf{z}$. A função de ativação $f$ é geralmente uma função não-linear, não-decrescente, limitada e também diferenciável tal como o função logística $f(u) = 1/(1+\exp^{-u})$ ou a tangente hiperbólica.

Essa função deve ser escolhida em relação à variável de resposta, assim como nos modelos lineares generalizados. A função logística é, por exemplo, apropriada para variáveis ​​resposta binárias, uma vez que mapeia a saída de cada neurônio para o intervalo $[0,1]$. O pacote neuralnet usa a mesma função de integração, bem como função de ativação para todos os neurônios.

Aprendizado supervisionado.


As redes neurais são estimadas por meio de um processo de treinamento da rede que usa os dados para "aprender". Especificamente, o pacote neuralnet concentra-se em algoritmos de aprendizado supervisionado.

Estes algoritmos de aprendizagem são caracterizados pela utilização de saídas (outputs, resultados ou ainda variáveis dependentes), as quais são comparadas com o valor predito pela rede neural, adaptando dinamicamente os valores dos parâmetros de modo que o "erro" seja minimizado.

Os parâmetros de uma rede neural são os seus pesos. Todos os pesos são geralmente iniciados com valores aleatórios provenientes de uma distribuição normal padrão. Durante um processo iterativo de formação da rede, as seguintes etapas são repetidas:


  • A rede neural calcula uma saída de $o(\mathbf{x})$ para as entradas dadas $\mathbf{x}$ e para os parâmetros correntes (pesos atuais). Se o processo de formação ainda não estiver concluído, os resultados previstos serão diferentes da saída $\mathbf{y}$ observada.
  • Uma função de erro, como a Soma dos Quadrados dos Erros (SSE - Sum of Squared Errors):
    ou a entropia cruzada:

    mede a diferença entre a saída prevista e o resultado observado, tal que $l=1,\dots,L$ representam os índices para as observações, ou seja, é o par ordenado com os dados de entrada e saída, e $H=1,\dots,H$ representam os nós de saída.
  • Todos os pesos são adaptados segundo alguma regra de aprendizagem definida a priori.

O processo termina se um critério pré-determinado é atingido, por exemplo, se todas as derivadas parciais da função de erro com respeito aos pesos $(\partial E/\partial \mathbf{w})$ são menores do que um dado limiar. Um algoritmo de aprendizagem amplamente utilizado é o algoritmo resilient backpropagation.

Resilient backpropagation.


O algoritmo resilient backpropagation é baseado no algoritmo de retropropagação tradicional, o qual modifica os pesos de uma rede neural, a fim de encontrar um mínimo local para a função de erro estipulada.

Em outras palavras, o gradiente da função de erro $(\partial E /\partial\mathbf{w})$ é calculado em relação aos pesos, a fim de encontrar uma raiz. Particularmente, os pesos são modificadas para irem na direção oposta das derivadas parciais até que um mínimo local seja atingido.

Esta ideia básica é aproximadamente ilustrada na figura abaixo retirada do texto de Günther e Fritsch (2010), para uma função de erro univariada:


Caso a derivada parcial seja negativa, o peso é aumentado (lado esquerdo da figura) e se a derivada parcial for positiva, o peso é reduzido (parte da direita da figura). Isto garante que um mínimo local para a função de erro seja atingido.

Todas as derivadas parciais são calculadas usando a regra da cadeia, desde que a função do cálculo de uma rede neural seja basicamente uma composição de funções de integração e ativação. Uma explicação detalhada é dada em Rojas (1996).

O pacote neuralnet possibilita a escolha do método entre o clássico backpropagation e o resilient backpropagation, com retrocesso do peso (Riedmiller, 1994) ou sem retrocesso de peso (Riedmiller e Braun, 1993) e também a versão modificada globalmente proposta por Anastasiadis et al. (2005).

Aplicação em finanças.

A aplicação de redes neurais em finanças não é nova. Wonga e Selvib (1998) apresentam uma ampla revisão da utilização de redes neurais em finanças entre os anos 1990 a 1996. Os autores investigaram a tendência de aplicações produzidas no período 1990-1996. Wonga e Selvib (1998) analisaram a literatura de acordo com os seguintes critérios: (1) ano de publicação, (2) área de aplicação, (3) domínio do problema, (4) fase do processo de decisão, (5) nível de gestão (6), nível de interdependência de tarefas, (7) meios de desenvolvimento, (8) de interação corporativa / acadêmica, (9) Tecnologia / técnica estatística, e (10) estudo comparativo.

Yoon e Swales (1991) apresentam uma discussão sobre a previsibilidade dos preços de ações por meio de redes neurais. Segundo os autores, a previsão do desempenho do preço de ações é um problema difícil e complexo. Técnicas multivariadas quantitativas e qualitativas têm sido repetidamente usadas para auxiliar na formação da expectativas dos investidores quanto aos preços de ações. Yoon e Swales (1991) analisaram a capacidade das redes neurais e seu poder de previsão em contraste com o método de análise discriminante.

Nesse post farei uma breve aplicação do método de redes neurais com o intuito de avaliar o poder de previsibilidade das ações por meio dessa ferramenta.

Inicialmente, vamos obter a série temporal (01/01/2001 a 31/12/2012) para o ativo PETR4.SA por meio do pacote quantmod:

#Limpa o Workspace
rm(list=ls())

#Habilita o pacote quantmod
library(quantmod)

#Início do período de interesse
inicio = as.Date("2001-01-01") 

#Fim do período de interesse
fim = as.Date("2012-12-31") 

#Obtêm os dados da PETR4
getSymbols("PETR4.SA", src="yahoo",from=inicio,to=fim)

Nesse caso, queremos tentar construir um preditor na forma de um Modelo Autoregressivo de ordem 5, isto é:

$y_{t}=\phi_{0}+\phi_{1}y_{t-1}+\phi_{2}y_{t-2}+\phi_{3}y_{t-3}+\phi_{4}y_{t-4}+\phi_{5}y_{t-5}$

Nesse caso, o valor da ação no tempo $t$ seria predita pelos $5$ valores (diários) que a antecedem:

#Dados para o neuralnet
t0<-as.numeric(Cl(PETR4.SA))            #Cinco dias antes
t0<-t0[-((length(t0)-4):length(t0))]

t1<-as.numeric(Cl(PETR4.SA)) [-1]       #Quatro dias antes
t1<-t1[-((length(t1)-3):length(t1))]

t2<-as.numeric(Cl(PETR4.SA)) [-c(1,2)]  #Três dias antes
t2<-t2[-((length(t2)-2):length(t2))]

t3<-as.numeric(Cl(PETR4.SA)) [-(1:3)]   #Dois dias antes
t3<-t3[-((length(t3)-1):length(t3))]

t4<-as.numeric(Cl(PETR4.SA)) [-(1:4)]   #Um dia antes
t4<-t4[-length(t0)]

t5<-as.numeric(Cl(PETR4.SA)) [-(1:5)]   #Variável dependente
Em seguida vamos dividir a série temporal em duas partes:
  1. Período de estimação (01/01/2001 até 31/12/2006).
  2. Período de validação (01/01/2007 até 31/12/2012).
#Cria a base
dados<-cbind(t1,t2,t3,t4,t5)

#Dados para estimação:
dados.Treina<-dados[1:1457,]

#Dados para validação
dados.Valida<-dados[1458:2917,]
Usando os dados para estimação e trabalhando com um modelo de redes neurais com 1 camada com 7 neurônios e admitindo o número máximo de iterações igual a 10000 e valor de corte (threshold) igual 1, a programação para estimar os parâmetros da rede é:
set.seed(12345)
library("neuralnet")
maxit<-as.integer(1000000)
nn <- neuralnet(dados.Treina[,5]~dados.Treina[,4]+
+dados.Treina[,3]+dados.Treina[,2]+dados.Treina[,1],
+data=dados.Treina, hidden=7,threshold =1,stepmax= maxit)
onde o comando fixa a semente para a geração de números aleatórios com o intuito de permitir a reprodução dos resultados obtidos.
CUIDADO!!
A programação acima pode demorar para ser concluída, por isso, use com parcimônia os valores do número máximo de iterações e parâmetro threshold.
Uma vez obtidos os valores para os parâmetros do modelo de redes neurais podemos analisar os resultados usando os comandos:
#Apresenta os valores para os pesos
nn$result.matrix

#Faz o gráfico do modelo
plot(nn)
O próximo passo é realizar a previsão para os dados de validação:
#Faz a previsão
previsao<-compute(nn,dados.Valida[,1:4])

#Valores da previsao
previsao.nn<-previsao$net.result
Outra hipótese bastante comum para as séries temporais financeiras é a Hipótese do Passeio Aleatório a qual pode ser representada matematicamente como: $y_{t}=\mu+y_{y-1}+\epsilon_{t}$ Assumindo que $\epsilon_{t}\sim N(0,\sigma^{2})$ podemos utilizar os dados de treinamento para estimar os parâmetros desse modelo:
#Gera as estimativas para o Random Walk
epsilon<-(dados.Treina[,5]-dados.Treina[,4])
mu<-mean(epsilon)
sigma2<-var(epsilon)

#Faz a previsao usando o Random Walk
previsao.rw<-dados.Valida[,4]+rnorm(nrow(dados.Valida),
+mu,sqrt(sigma2))
O gráfico comparativo entre a previsão via redes neurais e Passeio Aleatório contra os valores observados é elaborado usando o seguinte código:
#Monta a base com as previsões
Tempo<-seq(1458,2917)
previsao.todos<-as.data.frame(cbind(
+Tempo,dados.Valida[,5],previsao.nn,previsao.rw))
colnames(previsao.todos)<-c("Tempo","Obsevado",
+"Predito.NN", "Predito.RW")

#Faz o gráfico
#Faz o gráfico
library("ggplot2")
ggplot(previsao.todos, aes(Tempo)) + 
  geom_line(aes(y = Obsevado, colour = "Obsevado")) + 
  geom_line(aes(y = Predito.NN, colour = "Predito NN"))+
  geom_line(aes(y = Predito.RW, colour = "Predito RW"))+
  ggtitle("Séries Temporais")
É interessante notar que o modelo de Passeio Aleatório se ajustou melhor aos valores observados do que o modelo de redes neurais, especialmente quando a volatilidade apresentada era grande. Comparando a distribuição dos erros entre os dois métodos temos:
#Encontra os erros
erro.rw<-previsao.todos[,2]-previsao.todos[,4]
erro.nn<-previsao.todos[,2]-previsao.todos[,3]

#Une os dados
library("reshape")
df.m <- melt(cbind(erro.rw,erro.nn))

#Calcula as funções densidade via Kernel.
ggplot(df.m) + geom_density(aes(x = value,colour = X2)) 
+ labs(x = "Valores",y="Densidade") +
ggtitle("Densidade por meio do estimador Kernel.")
O gráfico de densidades demonstra que o modelo Passeio Aleatório apresenta menos variabilidade na previsão do que o modelo de redes neurais. Uma proposta seria incorporar ao modelo de redes neurais alguma covariável associada a volatilidade e comparar novamente os resultados ou ainda, adicionar mais camadas ocultas no modelo com o intuito de aumentar a não-linearidade.

terça-feira, 4 de dezembro de 2012

Estudo mapeia perfil do Administrador brasileiro.


Pesquisa foi realizada pelo Conselho Federal de Administração em parceria com a FIA


Homem jovem, com renda mensal entre 3,1 a 10 salários mínimos, empregados de empresas de grande porte do setor privado. Esse é o perfil do Administrador de Empresas revelado pela “Pesquisa Nacional sobre o Perfil, Formação, Atuação e Oportunidades de Trabalho do Administrador 2011”. O levantamento realizado pelo Conselho Federal de Administração (CFA) em parceria com a Fundação Instituto de Administração (FIA) acaba de ser divulgado e aponta tendências para a profissão de Administrador no país.

A pesquisa ouviu mais de 21.110 pessoas em todo o país entre Administradores, professores e coordenadores do curso de Administração e empresários. Apesar do levantamento apontar que a maioria – 65% - é formada por homens, a pesquisa revela que participação feminina é crescente na profissão, tendo elas atingido 35% de participação em 2011.

Para 25,41% dos 17.982 Administradores entrevistados o que motivou a escolha do curso de Administração foi o interesse em ter uma formação generalista e abrangente. “Hoje em dia a pessoa está mais preocupada com as oportunidades que o mercado de trabalho vai oferecer. Por isso, a vocação já não pesa na hora de decidir a carreira”, justifica o presidente do CFA, Adm. Sebastião Luiz de Mello.

Outro dado relevante é que a remuneração mensal do Administrador, em termos do total Brasil, situa-se entre 3,1 e 10 salários mínimos (43,37%), com a média aproximada de 9,75 salários mínimos. No entanto, foram observadas diferenças significativas na remuneração entre gêneros, empresas públicas e privadas, empresas micros, pequenas, médias e grandes e entre regiões do país.

O setor privado ainda é o que mais emprega Administradores de Empresa (58%). Nesse segmento, a maioria dos entrevistados – 46% - afirmou que trabalha em empresa de grande porte e 21,84% dos profissionais ocupam cargo de gerência.

Áreas de atuação - Cerca de 85% dos Administradores estão concentrados nas áreas de serviços em geral, indústria, comércio varejista, consultoria empresarial, instituições financeiras e serviços hospitalares e da saúde. O setor de serviços continuou sendo o que emprega maior número de Administradores, seguido do industrial.

Formação – Dos Administradores entrevistados pela Pesquisa, 84,18% concluíram o curso de Administração em instituição de ensino superior privada e informaram que o curso atendeu suas expectativas. Se, por um lado, os Administradores declaram-se satisfeitos com o que aprenderam nos cursos de graduação, por outro demonstraram ter encontrado dificuldades quando de seu ingresso no mercado de trabalho, pela falta de conteúdos nas disciplinas que os aproximassem das práticas.

O desenvolvimento do empreendedorismo, a gestão ambiental/ desenvolvimento sustentável e a gestão pública também foram indicados como novos conteúdos capazes de dinamizarem os projetos pedagógicos dos cursos de Administração. Já a Educação a Distância (EAD), apesar de estar em expansão, ela ainda não é bem aceita como modalidade de ensino, na opinião dos Administradores e dos Coordenadores/Professores participantes da pesquisa.

Com relação aos cursos de pós-graduação a maioria dos Administradores que participaram da pesquisa possui curso de especialização (75,33%) e pretende continuar seu aprendizado e atualização nas áreas da administração.

Características profissionais – A Pesquisa realizada pelo CFA aponta que o Administrador é um profissional com visão ampla da organização, tendo sido apontada como a característica predominante na sua identidade profissional pelos três segmentos da pesquisa: Administradores, Coordenadores/Professores de Administração, Empresários/Empregadores.

O comportamento ético é a atitude mais valorizada pelos entrevistados. Saber administrar pessoas e equipes e ter bom relacionamento interpessoal são as competências e habilidades apontadas como essenciais entre o público da pesquisa.

Tendências - Os empresários entendem que, nos próximos cinco anos, as áreas mais promissoras para a contratação de Administradores são: serviços, administração pública direta e indireta e indústria. “Na fase da pesquisa qualitativa ficou claro, ainda, que existem oportunidades de trabalho para o Administrador como consultor nas micro e pequenas empresas”, destacou o presidente do CFA.

As áreas mais promissoras para a contratação de Administradores, em termos de resultados gerais para o Brasil, são as de consultoria empresarial, serviços em geral e administração pública indireta, tendo, no entanto, sido observadas significativas diferenças regionais. Na Região Centro-Oeste, por exemplo, há uma crescente oportunidade na área do agronegócio. Já na Região Norte, umas das áreas com potencial para empregar Administradores é a do Comércio Atacadista.

Segundo Sebastião Mello, essa foi uma das maiores pesquisa, se não a maior realizada por meio da internet em todo o Brasil. “Tivemos participação maciça dos profissionais de Administração. Por meio da pesquisa conseguimos levantar informações sobre o ensino da Administração, as tendências profissionais para os Administradores, entre outros. Um verdadeiro raio X”, afirmou.

Ações do Sistema CFA/CRAs - Uma vez traçado o raio X da profissão, o Sistema CFA/CRAs, de posse desses dados, delineará ações a curto, médio e longo prazos para melhorar ainda mais esse cenário, além de promover e dignificar a profissão e o ensino da Administração de todo o país. “É nossa missão propor iniciativas coerentes com a realidade, mas antecipando futuro já que a expansão dos mercados mundiais é um desafio e, para estar preparado às mudanças, precisamos pensar em diretrizes de desenvolvimento para os profissionais de Administração”, diz Sebastião Mello, ressaltando que a pesquisa também servirá de guia para gestores públicos e privados, professores e profissionais de Administração que desejarem fazer a diferença.

Todos os dados da “Pesquisa Nacional sobre o Perfil, Formação, Atuação e Oportunidades de Trabalho do Administrador 2011” está disponível no endereço http://pesquisa.cfa.org.br. O acesso é gratuito.

Fonte:CFA.

terça-feira, 27 de novembro de 2012

Programação Linear no R.


A programação linear possui muitas aplicações nas Ciências Sociais e Exatas.

Nesse post mostrarei como solucionar problemas de programação linear no R por meio da biblioteca lpSolveAPI.

Considere o seguinte problema de programação linear:


O primeiro passo no R para a resolução desse problema é invocar a biblioteca lpSolveAPI, para isso utilizamos o seguinte comando:

#Chama a biblioteca
library(lpSolveAPI)

Como o problema possui somente duas variáveis vamos criá-lo com o nome de modelo.lp1 inicialmente sem nenhuma restrição:

#Define a criação de um modelo com 0 restrições e 2 variáveis
modelo.lp1 <- make.lp(0, 2)

#Dá o nome ao problema de programação linear
name.lp(modelo.lp1, "Exemplo 1 - Aula de MMQD 1")
Note que o comando make.lp recebe dois argumentos, o primeiro informa quantas restrições existem no problema e o segundo quantas variáveis. Inicialmente, colocamos zero restrições pois iremos adicioná-las dinamicamente nos próximos passos. Já o comando name.lp recebe dois argumentos, o primeiro argumento é o objeto modelo.lp1 que nós criamos e o segundo é o nome (ou descrição) do problema. Uma vez definida as principais características do problema de programação linear precisamos definir o domínio das variáveis e o tipo de problema (maximização ou minimização). Como nosso problema é um problema de maximação, escrevemos:
#Define as características do modelo
lp.control(modelo.lp1, sense="max")
Nesse comando, atribuímos ao modelo.lp1 o sentido de Maximização (isso é sense=''max'') para a função objetivo. Caso desejássemos Minimizar ao invés de maximizar escreveríamos sense=''min''. Como a função objetivo é escrita na forma $Minimize: Z=5x_{1} +6x_{2}$ devemos informar ao R que os coeficientes da função objetivo são, $5$ e $6$ respectivamente. Isso é feito por meio da seguinte sintaxe:
#Define a função objetivo
set.objfn(modelo.lp1, c(5,6))
Em seguida, como o problema pode assumir valores $x_{1}\geq 0,x_{2}\geq 0$ atribuímos os seguintes limites para as variáveis de decisão:
#Define os limites da região factível
set.bounds(modelo.lp1, lower = c(0,0), upper = c(Inf, Inf))

#Tipo das variáveis de decisão
set.type(modelo.lp1, c(1,2), type = c("real"))
No comando set.bounds informamos que a primeira variável possui limite inferior (lower) igual a zero e limite superior (upper) igual a infinito (Inf). O mesmo fazemos para a segunda variável, nesse caso dizemos que o limite inferior (lower) é igual a zero e o limite superior (upper) é igual a infinito (Inf). A ordem aqui importa, ou seja, caso a primeira variável estivesse contida entre zero e infinito e a segunda variável estivesse contida entre os valores 1 e 4 deveríamos escrever set.bounds(modelo.lp1, lower = c(0,1), upper = c(Inf, 4)). O comando set.type define o tipo de variável para cada uma das variáveis de decisão. É possível escolher as seguintes opções:
  1. integer - A variável só pode assumir valores inteiros.
  2. binary - A variável só pode assumir valores binários, isso é, 1 ou zero.
  3. real - A variável pode assumir valores nos reais.
O comando set.type informa ao objeto modelo.lp1 que as variáveis $x_{1}$ e $x_{2}$ (c(1,2)) são números reais. Mas o comando anterior, set.bounds diz ao R que as variáveis devem estar entre 0 e $\infty$, portanto, $x_{1}\geq 0$ e $x_{2}\geq 0$. O passo 3 é responsável pela adição das restrições no problema de Programação Linear. Vamos então adicionar uma restrição de cada vez. A primeira restrição é dada por: $x_{1} \le 6$ a qual pode ser escrita na forma $ 1x_{1}+0x_{2} \le 6$. Assim, a adição dessa restrição no objeto modelo.lp1 é feita da seguinte forma:
#Define os coeficientes da primeira restrição
coef1 <- c(1,0)

#Adiciona a restrição
add.constraint(modelo.lp1, coef1, "<=", 6)
Para a segunda restrição $2x_{2} \le 12\Rightarrow 0x_{1}+2x_{2} \le 12$, a adição é feita da seguinte forma:
#Define os coeficientes da segunda restrição
coef2 <- c(0,2)

#Adiciona a restrição
add.constraint(modelo.lp1, coef2, "<=", 12)
Finalmente, a última restrição $3x_{1}+2x_{2}\le 18$ é adicionada fazendo-se:
#Define os coeficientes da terceira restrição
coef3 <- c(3,2)

#Adiciona a restrição
add.constraint(modelo.lp1, coef3, "<=", 18)
Uma vez que o problema tenha sido configurado, todas as informações associadas a ele estão armazenadas no objeto modelo.lp1. Podemos visualizar essas informações fazendo:
#Mostra as informações do modelo
print(modelo.lp1)
Podemos também visualizar esse problema, uma vez que é um problema bidimensional, isso é, contém somente duas variáveis de decisão:
#Plota a região factível
plot(modelo.lp1)
Finalmente, para resolvê-lo, fazemos:
#Resolve o problema primal
solve(modelo.lp1)
resultado<-get.primal.solution(modelo.lp1)
print(resultado)
Entretanto, como os resultados não estão em um formato muito explicativo, vamos transformá-los em uma tabela (isso é um data.frame) e colocar títulos nas linhas e nas colunas:
#Transforma o resultado em uma tabela
solucao<-as.data.frame(resultado)

#Coloca os nomes nas colunas e nas linhas da tabela
names(solucao)<-c("Valores")
rownames(solucao)<-c("Função Objetivo", "Variável de folga 1","Variável de folga 2",
"Variável de folga 3","Solução X1", "Solução X2")

#Mostra os resultados com os nomes
print(solucao)

quinta-feira, 22 de novembro de 2012

Causalidade e Correlação


Causalidade é a relação entre um evento (a causa) e um segundo evento (o efeito), em que o segundo acontecimento é entendida como uma consequência do primeiro.

No uso comum, a causalidade é também a relação entre um conjunto de fatores (causas) e um fenômeno (o efeito). Qualquer coisa que afete um efeito, é denominada fator desse efeito. Um fator direto é um fator que afeta diretamente o efeito, isto é, sem quaisquer fatores intervenientes.

Compreender a relação causa-efeitoentre as variáveis ​​é de interesse primordial em muitos campos da ciência. Normalmente, a intervenção experimental é utilizada para avaliar estas relações.

Entre os métodos comuns para a avaliação da cause e efeito destacam-se:

  1. Variáveis Instrumentais.
  2. Equações estruturais.
  3. Redes Bayesianas.
  4. Modelos Gráficos.

Pacote pcalg


Suponha que temos um sistema descrito por algumas variáveis ​​e muitas observações obtidas deste sistema. Além disso, suponha que seja plausível a não existência de variáveis faltantes (omissão de variáveis) e também que no sistema não apresenta loops de feedback do sistema causal subjacente.

A estrutura causal de um sistema deste tipo pode ser convenientemente representado por um gráfico acíclico dirigido (DAG - Directed Acyclic Graph), em que cada nó representa uma variável e cada aresta representa uma causa direta.

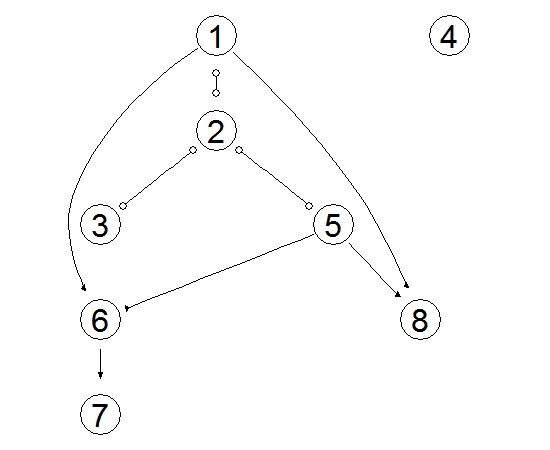
Por exemplo, suponha o seguinte grafo:


Nesse exemplo, a variável 1 causa a variável 2 diretamente, ou seja é um fator direto para a variável 2 mas é um fator interveniente da variável 5.

Usualmente, não se conhece a relação entre as variáveis a não ser que algum modelo teórico seja desenvolvido para explicar a relação entre as variáveis, e mesmo nesse caso o modelo necessita ser validado.

O caso mais comum ocorre quando não há qualquer informação quanto ao comportamento causal dessas variáveis, nesse caso o objetivo é estimar essas relações e apresentar o grafo causal estimado.

Os modelos implementados no pacote pcalg são capazes de estimar o grafo causal das variáveis de uma base de dados mesmo que nenhum modelo seja conhecido a priori.

Os métodos implementados são o Algoritmo PC (Spirtes et al., 2000), Algoritmo FCI (Spirtes et al. ,1999), Algoritmo RFCI (Colombo et al., 2012) e o Método IDA (Maathuis et al., 2009).

Alguns pressupostos para cada um dos algoritmos implementados no pacote pcalg são apresentados abaixo:

  • Algoritmo PC: Nenhuma variável oculta existe ou deixou de ser selecionada.
  • Algoritmo FCI: Permite a existência de variável oculta ou omissão de variáveis.
  • Algoritmo RFCI: Permite a existência de variável oculta ou omissão de variáveis.
  • Método IDA: Nenhuma variável oculta existe ou deixou de ser selecionada.

Prática no R.


Antes de instalar o pacote pcalg no R é necessário instalar dois pacotes:


Para a representação de gráficos, o pacote pcalg utiliza dois outros pacotes chamados RBGL e o pacote graph.

Estes pacotes não estão disponíveis no CRAN, mas estão no outro repositório do software R, BioConductor.

Para instalá-los, siga as instruções abaixo:

#Instala os pacotes necessários.
source("http://bioconductor.org/biocLite.R") 
biocLite("RBGL")
biocLite("Rgraphviz")

Após a instalação desses pacotes, instale normalmente o pacote pcalg. Como exemplo utilizaremos dados simulados pelos autores do pacote pcalg.

Esses dados foram construídos de modo a possuírem a estrutura gráfica apresentada anteriormente. Aqui, realizaremos estimativas com base nos dados para avaliar se os métodos gráficos implementados no pcalg conseguem identificar corretamente a estrutura gráfica original.

Devemos inicialmente habilitar o pacote pcalg e em seguida ler o conjunto de dados que desejamos explorar:

#Habilita o pacote pcal
library("pcalg")

#Lê os dados simulados
dados.df<-read.csv("http://dl.dropbox.com/u/36068691/DadosPCALG.csv",sep=" ")
O primeiro método que utilizaremos é o Algoritmo PC:
#Gera as Estatísticas Suficientes
estatisticas  <-  list(C  =  cor(dados.df),  n  =  nrow(dados.df))

#Executa o Algoritmo PC
pc.fit  <-  pc(estatisticas,  indepTest  =  gaussCItest, p  =  ncol(dados.df),  alpha  =  0.01)

#Plota os resultados
plot(pc.fit,  main  =  "Algoritmo PC.")
Na primeira parte do comando a lista estatisticas armazena a Matriz de Correlações e o tamanho da amostra (número de observações na base). Essas informações são suficientes para a execução do Algoritmo PC. Em seguida a função pc(.) executa o Algoritmo PC. O comando "gaussCItest" testa a independência condicional assumindo que as variáveis possuem distribuição normal a um nível de significância de 0.01. O resultado obtido fornece o seguinte grafo:
Note que o grafo gerado está muito próximo da estrutura verdadeira, os desvios ocorrem devido ao tamanho amostral e flutuações estocásticas. Por exemplo, a relação entre as variáveis 1 e 6 foi apresentada corretamente, mas a relação entre as variáveis 1 e 2 apresenta uma relação bidirecional, o que não é verdade para os dados simulados. O próximo algoritmo a ser utilizado é o Algoritmo FCI. O Algoritmo FCI é uma generalização do Algoritmo PC, no sentido de permitir a existência de muitas possíveis variáveis latentes (omitidas) no modelo. A execução do Algoritmo FCI é similar ao do Algoritmo PC:
#Executa o Algoritmo FCI
fci.fit  <-  fci(estatisticas,  indepTest  =  gaussCItest, p  =  ncol(dados.df),  alpha  =  0.01)

#Plota os resultados
plot(fci.fit,  main  =  "Algoritmo FCI.")
O grafo obtido usando esse algoritmo foi:
Note que nesse caso, algumas relações foram identificadas mas a direção não pode ser estimada. Por exemplo, a variável 1 causa a variável 6, mas a relação entre a variável 1 e a variável 2 não pode ser identificada... A única informação que temos é que possivelmente as variáveis 1 e 2 se relacionam mas não sabemos como. Para o Algoritmo RFCI utilizamos a seguinte sintaxe:
#Executa o Algoritmo RFCI
rfci.fit  <-  rfci(estatisticas,  indepTest  =  gaussCItest, p  =  ncol(dados.df),  alpha  =  0.01)

#Plota os resultados
plot(rfci.fit,  main  =  "Algoritmo RFCI.")
O Algoritmo RFCI é similar ao Algoritmo FCI. No entanto, esse é mais rápido em sua execução. O grafo produzido, nesse caso, é idêntico ao Algoritmo FCI:
Por fim, o último algoritmo é o Método IDA. Esse método, diferente dos demais algoritmos mensura o grau de relação entre as variáveis. Por exemplo, se desejamos saber qual o grau de efeito entre as variáveis 1 e 6 (variável 1 causando a variável 6) utilizamos o seguinte código:
#Executa o Método IDA para o Algoritmo PC
ida(1, 6, cov(dados.df), pc.fit@graph)
O comando retorna os seguintes valores [0.7536376 0.5487757]. Isso significa que a magnitude do efeito da variável 1 sobre a variável 6 é algum valor nesse intervalo. Uma vez que ambos os valores são maiores do que zero, podemos concluir que a variável 1 apresenta um efeito positivo causal sobre a variável 6. Esses valores refletem o efeito do aumento em uma unidade na variável 1 em relação a variável 6. Em alguns casos quando se conhece determinadas relações entre as variáveis, é possível fixar relações e permitir que os algoritmos busquem apenas as relações de causalidade desconhecidas, nesses casos utiliza-se os comandos fixedGaps e fixedEdges.


terça-feira, 13 de novembro de 2012

Modelos de mediação.


Em muitos campos da ciência o objetivo dos pesquisadores não é apenas estimar o efeito causal de um tratamento, mas também a compreensão do processo no qual o tratamento afeta o resultado de maneira causal.

A análise de mediação causal é frequentemente usada para avaliar os potenciais mecanismos causais.

Estudiosos de diversas disciplinas estão cada vez mais interessados ​​em identificar mecanismos causais, indo além da estimativa dos efeitos causais e explorando por completo o modelo causal.

Uma vez que certas variáveis foram identificadas como responsáveis pelo efeito causal associado a um determinado resultado, o próximo passo é entender como essas variáveis ​​exercem influência.

Nesses casos, o procedimento padrão para analisar os mecanismos causais na pesquisa aplicada é chamada análise de mediação. Nessas análises um conjunto de modelos de regressão, são ajustados e, em seguida, as estimativas dos "efeitos de mediação" são calculados a partir dos modelos ajustados (por exemplo, Haavelmo 1943; Baron e Kenny 1986; Shadish, Cook e Campbell 2001; MacKinnon 2008).

Pacote mediation.


O pacote de mediation do R permite aos usuários:

  1. Investigar o papel dos mecanismos causais utilizando diferentes tipos de dados e modelos estatísticos.
  2. Explorar como os resultados mudam quando os pressupostos são relaxados (análise de sensibilidade).
  3. Calcular medidas de interesse em diversos projetos de pesquisa.

A prática corrente na análise de mediação atualmente são inferências baseadas em modelos. Em um delineamento experimental, a variável tratamento é randomizada e as variáveis de mediação e os resultados são observados.

Imai et ai. (2010) mostram que uma gama de modelos paramétricos e semi-paramétrico podem ser utilizados para estimar o efeito médio causal média e mediação causal e outras quantias de interesse.

Aplicação usando o pacote mediation.

Para ilustrar o procedimento utilizaremos como exemplo os dados obtidos por Brader, Valentino e Suhat (2008).

Brader et al. (2008) conduziram um experimento casualizado onde os indivíduos foram expostos a diferentes histórias sobre a imigração. O objetivo era investigar como o seu enquadramento os influencia as atitudes e comportamentos políticos em relação à política de imigração.

#Habilita o pacote mediation
library("mediation")

#Lê os dados
dados.df<-read.csv("http://dl.dropbox.com/u/36068691/dadosMediacao.csv")
Os autores postularam a ansiedade (variável emo) como variável mediadora do efeito causal para o enquadramento na opinião pública. O primeiro passo é ajustar o modelo de mediação para a medida de ansiedade (variável emo), essa é modelada como uma função da variável tratamento (treat) e co-variáveis ​​de pré-tratamento como (idade - age, educ, gênero - gender e renda - income).
# Modelo de mediação
med.fit <- lm(emo ~ treat + age + educ + gender + income, data = dados.df)
Em seguida, modelamos a variável resultado, a qual é uma variável binária que indica se o participante concordou em enviar uma carta sobre a política de imigração ao seu membro do Congresso (variável cong_mesg). As variáveis ​​explicativas do modelo incluem a variável de mediação, a variável de tratamento, e o mesmo conjunto de variáveis de pré-tratamento ​​como as utilizadas no modelo de mediação.
# Modelo para o resultado
out.fit <- glm(cong_mesg ~ emo + treat + age + educ + gender + income, data = dados.df, family = binomial("probit"))
Neste exemplo, espera-se que o tratamento aumente a resposta emocional dos entrevistados, que por sua vez é postulado fazer com que os respondentes sejam mais propensos a enviar uma carta ao seu membro do Congresso. Inicialmente usamos um modelo de regressão linear e regressão de probit para os modelos de mediação e o modelo para o resultado, respectivamente. Vamos agora usar o modelo de mediação para estimar os efeitos médios causais diretos (ACME - Average Causal Mediation effects). Para isso, basta executar o seguinte código:
#Habilita o pacote sandwich
library(sandwich)

#Estima os efeitos médios
med.out <- mediate(med.fit, out.fit, treat = "treat", mediator = "emo", robustSE = TRUE)

#Apresenta as estimativas
summary(med.out)
Como argumentos para esta função, é necessário especificar os modelos (neste caso, med.fit e out.fit), bem como o nome da variável de tratamento e da variável de mediação, que são representados como treat = "treat" e mediator = "emo", respectivamente. Além disso, usamos a matriz de variâncias e covariâncias robustas para a heterocedasticidade oriunda do pacote de sandwich. Ao executar o comando, o seguinte resultado surge:
Nesse exemplo, utilizou-se 1000 simulações para que o erro-padrão das estimativas fossem obtidos. Neste exemplo, os efeitos médios causais diretos (ACME - Average Causal Mediation effects) estimados são estatisticamente significantes e portanto, diferentes de zero, mas as estimativas dos efeitos diretos para médio e total não são. Em outras palavras, os resultados sugerem que o tratamento no ensaio pode ter aumentado a resposta emocional, que por sua vez tornou os indivíduos mais propensos a enviar uma mensagem ao seu congressista. Aqui, uma vez que a variável resultado é binária todos os efeitos estimados são expressos como uma alteração na probabilidade do respondente enviar uma mensagem ao Congresso. O pacote mediation apresenta outras opções como a possibilidade de análises gráficas, análises por segmentos e múltiplas entradas. Para maiores detalhes veja Tingley et. al (2012).