SAUDAÇÕES!

Seja bem vindo à página do professor Pedro Albuquerque. Para saber mais sobre meu currículo, disciplinas ministradas e interesses de pesquisa, navegue no menu disponível no topo da página.
Mostrando postagens com marcador R-project. Mostrar todas as postagens

terça-feira, 15 de setembro de 2015

Credit Score usando o R.


Credit Scoring é definido como sendo um modelo estatístico/econométrico o qual atribui uma medida de risco aos clientes de uma instituição financeira ou aos futuros clientes.

Usualmente, a avaliação dos clientes é realizada por meio de um Credit Scorecard o qual é um modelo estatístico para avaliação do risco estruturado de maneira a facilitar a tomada de decisão quanto a liberação do crédito ou não.

O uso de credit scorecard é muito popular principalmente para as organizações que lidam empréstimos como bancos.

Dentre as vantagens da utilização de um credit scorecard podemos listar:

  1. Credit Scorecard é implementado facilmente e pode ser monitorado ao longo do tempo.
  2. Pessoas sem o conhecimento técnico em estatística ou econometria podem utilizar facilmente o credit scorecard para tomar decisões.

As principais questões em Credit Score são:

  1. Quem receberá o crédito ?
  2. Quanto deverá ser esse crédito ?
  3. Quais as estratégias para a distribuição e cobrança do crédito ?

Em outras palavras, Credit Score é um conjunto de modelos de decisão e técnicas estatísticas subjacentes que auxiliam os credores na tomada de decisão quanto a concessão de crédito ao consumidor.

Estas técnicas informam quem receberá o crédito, quanto crédito deverá ser fornecido e quais estratégias operacionais melhorarão a rentabilidade dos devedores para os credores (Thomas, Eldelman e Crook, 2002).

Credit Score usando o R.

Para demonstrar como o Credit Score pode ser formulado usando o R, iremos trabalhar com os dados German.csv o qual representa um conjunto de dados de crédito para uma instituição financeira Alemã.

Os dados são compostos por 300 empréstimos "ruins" (por exemplo, ausência de pagamento ou atraso) e 700 empréstimos "bons" (por exemplo, pagamentos sem atraso). O objetivo é fornecer insumos para a tomada de decisão quanto aos futuros empréstimos com base nos padrões anteriormente observados.

É comum em Credit Score classificar as contas "ruins" como aquelas contas que em algum período de tempo apresentaram inadimplência por 60 dias ou mais (em empréstimos hipotecários, 90 dias ou mais é por vezes utilizado).

Vamos importar os dados para o R:

#Limpa o Workspace
rm(list=ls())

#Importa os dados German.csv 
dados.df<-read.csv("https://dl.dropboxusercontent.com/u/36068691/Blog/german.csv")

#Apresenta as variáveis do DataFrame
names(dados.df)

#Apresenta a estrutura do DataFrame
str(dados.df)
No R as variáveis categóricas ou binárias são usualmente tratadas como fatores enquanto as variáveis contínuas ou discretas são tratadas como valores numéricos. Nesse caso, algumas conversões são necessárias:
#Transforma em fatores as variáveis categóricas e "dummies"
dados.df[,"CHK_ACCT"]     <-as.factor(dados.df[,"CHK_ACCT"])
dados.df[,"HISTORY"]      <-as.factor(dados.df[,"HISTORY"])
dados.df[,"NEW_CAR"]      <-as.factor(dados.df[,"NEW_CAR"])
dados.df[,"USED_CAR"]     <-as.factor(dados.df[,"USED_CAR"])
dados.df[,"FURNITURE"]    <-as.factor(dados.df[,"FURNITURE"])
dados.df[,"RADIO.TV"]     <-as.factor(dados.df[,"RADIO.TV"])
dados.df[,"EDUCATION"]    <-as.factor(dados.df[,"EDUCATION"])
dados.df[,"RETRAINING"]   <-as.factor(dados.df[,"RETRAINING"])
dados.df[,"SAV_ACCT"]     <-as.factor(dados.df[,"SAV_ACCT"])
dados.df[,"EMPLOYMENT"]   <-as.factor(dados.df[,"EMPLOYMENT"])
dados.df[,"MALE_DIV"]     <-as.factor(dados.df[,"MALE_DIV"])
dados.df[,"MALE_SINGLE"]  <-as.factor(dados.df[,"MALE_SINGLE"])
dados.df[,"MALE_MAR"]     <-as.factor(dados.df[,"MALE_MAR"])
dados.df[,"CO.APPLICANT"] <-as.factor(dados.df[,"CO.APPLICANT"])
dados.df[,"GUARANTOR"]    <-as.factor(dados.df[,"GUARANTOR"])
dados.df[,"TIME_RES"]     <-as.factor(dados.df[,"TIME_RES"])
dados.df[,"REAL_ESTATE"]  <-as.factor(dados.df[,"REAL_ESTATE"])
dados.df[,"PROP_NONE"]    <-as.factor(dados.df[,"PROP_NONE"])
dados.df[,"OTHER_INSTALL"]<-as.factor(dados.df[,"OTHER_INSTALL"])
dados.df[,"RENT"]         <-as.factor(dados.df[,"RENT"])
dados.df[,"OWN_RES"]      <-as.factor(dados.df[,"OWN_RES"])
dados.df[,"NUM_CREDITS"]  <-as.factor(dados.df[,"NUM_CREDITS"])
dados.df[,"JOB"]          <-as.factor(dados.df[,"JOB"])
dados.df[,"NUM_DEPEND"]   <-as.factor(dados.df[,"NUM_DEPEND"])
dados.df[,"TELEPHONE"]    <-as.factor(dados.df[,"TELEPHONE"])
dados.df[,"FOREIGN"]      <-as.factor(dados.df[,"FOREIGN"])

#Variável dependente
dados.df[,"RESPONSE"]     <-as.factor(dados.df[,"RESPONSE"])

#Transforma em numeric
dados.df[,"AMOUNT"]       <-as.numeric(dados.df[,"AMOUNT"])
dados.df[,"INSTALL_RATE"] <-as.numeric(dados.df[,"INSTALL_RATE"])
dados.df[,"AGE"]          <-as.numeric(dados.df[,"AGE"])
dados.df[,"NUM_DEPEND"]   <-as.numeric(dados.df[,"NUM_DEPEND"])
dados.df[,"DURATION"]     <-as.numeric(dados.df[,"DURATION"])
O próximo passo é separar os dados em dois grupos:
  1. Dados para estimação. (Treinamento)
  2. Dados para teste. (Validação)
Uma sugestão é separar a base de dados (aleatoriamente) da seguinte forma: 60% das observações deverão compor a base de treinamento e 40% a base de validação:
#Índices obtidos após a aleatorização
ordena <- sort(sample(nrow(dados.df), nrow(dados.df)*.6))

#Dados para o treinamento
treinamento<-dados.df[ordena,]

#Dados para a validação
validacao<-dados.df[-ordena,]
A ideia é construir o(s) modelo(s) de Credit Scoring com o DataFrame "treinamento" e em seguida avaliar o ajuste com o DataFrame "validacao". Uma das formas mais simples para modelar os dados de crédito é por meio da regressão logística:
#Índices obtidos após a aleatorização
ordena = sort(sample(nrow(dados.df), nrow(dados.df)*.6))

#Dados para o treinamento
treinamento<-dados.df[ordena,]

#Dados para a validação
validacao<-dados.df[-ordena,]
Como há muitas possíveis variáveis para o modelo, podemos proceder com a abordagem de Stepwise para selecionar o modelo com a "melhor" combinação de variáveis explicativas:
#Regressão Logística
modelo.completo <- glm(RESPONSE ~ . ,family=binomial,data=treinamento)

#Abordagem Stepwise para seleção de variáveis
stepwise <- step(modelo.completo,direction="both") 
Após algumas iterações, observa-se que o conjunto de variáveis com o menor valor para o Critério de Informação de Akaike é:
#Modelo com as variáveis indicadas pelo Stepwise
stepwise <- glm(RESPONSE ~  JOB+NUM_CREDITS+EMPLOYMENT+RETRAINING+NEW_CAR+TELEPHONE+MALE_DIV+
                  FURNITURE+PROP_NONE+MALE_MAR+RENT+NUM_DEPEND+REAL_ESTATE+EDUCATION+FOREIGN+
                  TIME_RES, family=binomial,data=treinamento)

#Resume os resultados do modelo
summary(stepwise)
Percebemos que nem todas as variáveis são significantes:
Uma medida interessante para interpretar o modelo é a medida de Razão de chances (Odds Ratio):
#Calcula a razão de chances
exp(cbind(OR = coef(stepwise), confint(stepwise)))
Obtemos como resultados as seguintes Razões de chance:
E como dito anteriormente, a interpretação é bem interessante. Veja por exemplo a variável NUM_DEPEND, nesse caso, para cada dependente a mais que um proponente possui isso aumenta a sua chance de ser considerado inadimplente em aproximadamente 12%. Finalmente, vamos testar a qualidade do modelo aplicando o modelo estimado na base de validação para termos uma ideia do grau de acerto desse modelo:
#Faz a previsão para a base de validação (probabilidade)
predito<-predict(stepwise,validacao,type="response")

#Escolhe quem vai ser "1" e quem vai ser "0"
predito<-ifelse(predito>=0.8,1,0)
  
#Compara os resultados
table(predito,validacao$RESPONSE)
Obtemos assim a seguinte matriz de confusão:

Logo a nossa taxa de acerto (acurácia) nesse modelo é dada por:

$
Tx.Acerto=\frac{75+166}{400}=\frac{241}{400} \approx 60\%
$

Podemos melhorar a taxa de acerto refinando o modelo por meio da exclusão de variáveis não significantes e pela inclusão de componentes estatisticamente significantes.

quarta-feira, 15 de julho de 2015

Revolution R - Parte 3.


Vimos anteriormente no post Revolution R - Parte 2 como manipular bases de dados importadas para o ambiente Revolution R. Nesse post veremos como importar dados brutos das pesquisas do IBGE. Considere por exemplo, os dados da Pesquisa Nacional por Amostra de Domicílios - PNAD 2011.

Após baixar os microdados podemos criar o dataset no formato nativo *.XDF do Revolution R da seguinte forma:

#Define o working directory
setwd("C:/PNAD2011/Dados")

#Define as variáveis e seu tipo
colList <- list(
"V0101"=list(type="factor", start=1, width=4,description="Ano de referência"),
"UF"=list(type="factor", start=5, width=2,description="Unidade da Federação"),
"V0102"=list(type="factor", start=5, width=8,description="Número de controle"),
"V0103"=list(type="factor", start=13, width=3,description="Número de série"),
"V0104"=list(type="factor", start=16, width=2,description="Tipo de entrevista"),
"V0105"=list(type="factor", start=18, width=2,description="Total de moradores"),
"V0106"=list(type="factor", start=20, width=2,description="Total de moradores de 10 anos ou mais"),
"V0201"=list(type="factor", start=22, width=1,description="Espécie do domicílio"),
"V0202"=list(type="factor", start=23, width=1,description="Tipo do domicílio"),
"V0203"=list(type="factor", start=24, width=1,description="Material predominante na construção das paredes externas do prédio"),
"V0204"=list(type="factor", start=25, width=1,description="Material predominante na cobertura (telhado) do domicílio"),
"V0205"=list(type="integer", start=26, width=2,description="Número de cômodos do domicílio"),
"V0206"=list(type="integer", start=28, width=2,description="Número de cômodos servindo de dormitório"),
"V0207"=list(type="factor", start=30, width=1,description="Condição de ocupação do domicílio"),
"V0208"=list(type="numeric", start=31, width=12,description="Aluguel mensal pago no mês de referência"),
"V0209"=list(type="numeric", start=43, width=12,description="Prestação mensal paga no mês de referência"),
"V0210"=list(type="factor", start=55, width=1,description="Terreno onde está localizado o domicílio é próprio"),
"V0211"=list(type="factor", start=56, width=1,description="Tem água canalizada em pelo menos um cômodo do domicílio"),
"V0212"=list(type="factor", start=57, width=1,description="Proveniência da água canalizada utilizada no domicílio"),
"V0213"=list(type="factor", start=58, width=1,description="Água utilizada no domicílio é canalizada de rede geral de distribuição para a propriedade"),
"V0214"=list(type="factor", start=59, width=1,description="Água utilizada no domicílio é de poço ou nascente localizado na propriedade"),
"V0215"=list(type="factor", start=60, width=1,description="Tem banheiro ou sanitário no domicílio ou na propriedade"),
"V0216"=list(type="factor", start=61, width=1,description="Uso do banheiro ou sanitário"),
"V2016"=list(type="integer", start=62, width=2,description="Número de banheiros ou sanitários"),
"V0217"=list(type="factor", start=64, width=1,description="Forma de escoadouro do banheiro ou sanitário"),
"V0218"=list(type="factor", start=65, width=1,description="Destino do lixo domiciliar"),
"V0219"=list(type="factor", start=66, width=1,description="Forma de iluminação do domicílio"),
"V0220"=list(type="factor", start=67, width=1,description="Tem telefone móvel celular"),
"V2020"=list(type="factor", start=68, width=1,description="Tem telefone fixo convencional"),
"V0221"=list(type="factor", start=69, width=1,description="Tem fogão de duas ou mais bocas"),
"V0222"=list(type="factor", start=70, width=1,description="Tem fogão de uma boca"),
"V0223"=list(type="factor", start=71, width=1,description="Tipo de combustível utilizado no fogão"),
"V0224"=list(type="factor", start=72, width=1,description="Tem filtro d’água"),
"V0225"=list(type="factor", start=73, width=1,description="Tem rádio"),
"V0226"=list(type="factor", start=74, width=1,description="Tem televisão em cores"),
"V0227"=list(type="factor", start=75, width=1,description="Tem televisão em preto e branco"),
"V2027"=list(type="factor", start=76, width=1,description="Tem aparelho de DVD"),
"V0228"=list(type="factor", start=77, width=1,description="Tem geladeira"),
"V0229"=list(type="factor", start=78, width=1,description="Tem freezer"),
"V0230"=list(type="factor", start=79, width=1,description="Tem máquina de lavar roupa"),
"V0231"=list(type="factor", start=80, width=1,description="Tem microcomputador"),
"V0232"=list(type="factor", start=81, width=1,description="Microcomputador é utilizado para acessar a Internet"),
"V2032"=list(type="factor", start=82, width=1,description="Tem carro ou motocicleta de uso pessoal"),
"V4105"=list(type="factor", start=83, width=1,description="Código de situação censitária"),
"V4107"=list(type="factor", start=84, width=1,description="Código de área censitária"),
"V4600"=list(type="factor", start=85, width=2,description="Dia de referência"),
"V4601"=list(type="factor", start=87, width=2,description="Mês de referência"),
"V4602"=list(type="factor", start=89, width=4,description="Estrato"),
"V4604"=list(type="integer", start=93, width=2,description="Número de municípios selecionados no estrato"),
"V4605"=list(type="numeric", start=95, width=12,description="Probabilidade do município"),
"V4606"=list(type="integer", start=107, width=3,description="Número de setores selecionados no município"),
"V4607"=list(type="numeric", start=110, width=12,description="Probabilidade do setor"),
"V4608"=list(type="factor", start=122, width=6,description="Intervalo de seleção do domicílio"),
"V4609"=list(type="numeric", start=128, width=9,description="Projeção de população"),
"V4610"=list(type="numeric", start=137, width=3,description="Inverso da fração"),
"V4611"=list(type="numeric", start=140, width=5,description="Peso do domicílio"),
"V4614"=list(type="numeric", start=145, width=12,description="Rendimento mensal domiciliar para todas as unidades domiciliares (exclusive o rendimento das pessoas cuja condição na unidade domiciliar era pensionista, empregado doméstico ou parente do empregado doméstico e das pessoas de menos de 10 anos de idade)"),
"UPA"=list(type="numeric", start=157, width=4,description="Delimitação do município"),
"V4617"=list(type="factor", start=161, width=7,description="STRAT - Identificação de estrato de município auto-representativo e não auto-representativo"),
"V4618"=list(type="factor", start=168, width=7,description="PSU - Unidade primária de amostragem"),
"V4620"=list(type="integer", start=175, width=2,description="Número de componentes do domícilio (exclusive as pessoas cuja condição na unidade domiciliar era pensionista, empregado doméstico ou parente do empregado doméstico)"),
"V4621"=list(type="numeric", start=177, width=12,description="Rendimento mensal domiciliar per capita"),
"V4622"=list(type="factor", start=189, width=2,description="Faixa do rendimento mensal domiciliar per capita"),
"V4624"=list(type="factor", start=191, width=1,description="Forma de abastecimento de água"),
"V9992"=list(type="character", start=192, width=8,description="Data de geração do arquivo de microdados")
)
#Endereço dos microdados
pnadFile <- file.path("C:/PNAD2011/Dados", "DOM2011.DAT")

#Especficação para a importação
sourceData <- RxTextData(pnadFile, colInfo=colList)
outputData <- RxXdfData("DOM2011.xdf")
rxImport(sourceData, outputData, overwrite = TRUE)
Note que cada variável possui um tipo definido (integer, numeric ou factor), sua posição incial e final no arquivo texto DOM2011.DAT além de um descritor. Essas informações estão disponíveis no dicionário da PNAD 2011. Outro comentário importante, é o fato da linha número 70 especificar o local em que os dados da PNAD foram extraídos. Uma vez importados esses dados, podemos realizar algumas operações de interesse, por exemplo:
#Confere o formato das variáveis
rxGetInfoXdf("DOM2011.xdf", getVarInfo=TRUE)

#Remove as observações com peso missing ou negativo
rxDataStep(inData = "DOM2011.xdf", outFile = "DOM2011.xdf",rowSelection=(V4611>0),overwrite=TRUE)

#Estatísticas por UF usando somente a média
mun<-rxSummary(~V2016:UF, data = "DOM2011.xdf",
 fweights = "V4611",summaryStats ="Mean")
print(mun)
Nos próximos posts sobre o Revolution R utilizaremos a base de dados criada e citada aqui, qual seja:DOM2011.xdf.

quinta-feira, 15 de janeiro de 2015

Processamento e paralelo no R.


A computação paralela é uma forma de computação na qual muitos cálculos que são realizados em simultaneamente, aumentando assim a velocidade de execução de determinados códigos. Esse tipo de processamento opera no princípio de que grandes problemas muitas vezes podem ser divididos em partes menores, que são então resolvidos simultaneamente ("em paralelo"). O possível aumento de velocidade máxima de um único programa, como resultado de paralelização é conhecida como Lei de Amdahl.

No R podemos trabalhar com a computação em paralelo por meio de dois pacotes, a saber: foreach e doParallel.

Inicialmente é necessário instalar e carregar os pacotes de interesse:

#Carrega os pacotes necessários para realizar o paralelismo
library(foreach)
library(doParallel)

Cada núcleo existente na sua máquina (ou uma parte deles) pode ser utilizado para se dividir as tarefas e, consequentemente, os cálculos, para isso, precisamos saber quantos núcleos temos disponíveis:

#Checa quantos núcleos existem
ncl<-detectCores()
ncl

#Registra os clusters a serem utilizados
cl <- makeCluster(ncl)
registerDoParallel(cl)
Note que podemos registrar menos clusters do que temos disponíveis, caso você não deseje que sua máquina fique "travada" realizando somente as operações de cálculo exigidas. Para testar a velocidade que o processamento em paralelo trás para o nosso código vamos inicialmente gerar uma base de dados:
#Gera o número de observações
n<-1000

#Variáveis geradas
x<-rnorm(n,0,1)
y<-rnorm(n,1+2*x,2)

#Dataframe com as variáveis geradas
dados<-data.frame(x,y)
Em seguida, vamos realizar o Bootstrap usando a função for usual do R para computar o Erro-Padrão dos parâmetros do modelo de regressão na forma: $y=\alpha+\beta x +\epsilon$ O código é dado por:
#Inicia a contagem do tempo
ptm <- proc.time()

#Cria o vetor para armazenar o parãmetro beta em cada iteração Bootstrap
beta<-rep(0,5000)

#Faz o Bootstrap usando a função for
for(i in 1:5000)
{
  #Gera a amostra Bootstrap
  bdados<-dados[sample(nrow(dados),nrow(dados),replace=T),]
  beta[i]<-unname(lm(y~x,bdados)$coef[2])
}
mean(beta)
sd(beta)

#Para de contar o tempo
proc.time() - ptm
Os resultados para a minha máquina com 4 núcleos e utilizando for foi:
Agora podemos usar a função foreach sem paralelismo para comparar também:
#Inicia a contagem do tempo
ptm <- proc.time()

#Cria o vetor para armazenar o parãmetro beta em cada iteração Bootstrap
beta<-rep(0,5000)

#Faz o Bootstrap usando a função foreach
boot_b <- foreach(i=1:5000, .combine=c) %do% {
  #Gera a amostra Bootstrap
  bdados<-dados[sample(nrow(dados),nrow(dados),replace=T),]
  beta[i]<-unname(lm(y~x,bdados)$coef[2])
}
mean(beta)
sd(beta)

#Para de contar o tempo
proc.time() - ptm
Os resultados foram mais demorados do que utilizando somente o for:
Finalmente, podemos considerar realizar essas tarefas em paralelo, distribuindo os cálculos entre os núcleos registrados:
#Inicia a contagem do tempo
ptm <- proc.time()

#Cria o vetor para armazenar o parãmetro beta em cada iteração Bootstrap
beta<-rep(0,5000)

#Faz o Bootstrap usando a função foreach
boot_b <- foreach(i=1:5000, .combine=c) %dopar% {
  #Gera a amostra Bootstrap
  bdados<-dados[sample(nrow(dados),nrow(dados),replace=T),]
  beta[i]<-unname(lm(y~x,bdados)$coef[2])
}
mean(boot_b)
sd(boot_b)

#Para de contar o tempo
proc.time() - ptm

#Stop clusters
stopCluster(cl)

Usando o paralelismo, o Bootstrap foi muito mais rápido:
Nota-se que o processamento em paralelo realmente é vantajoso, mas outras funções como a família apply, sapply, lapply, mapply, etc. também são muito boas quando deseja-se que o código rode o mais rapidamente possível.

sexta-feira, 14 de novembro de 2014

Revolution R - Parte 1.


Hoje uma grande queixa em relação ao uso do R é a dificuldade de lidar com grandes bases de dados (Big Data), nesse sentido, o software Revolution R tem apresentado bons resultados, pois além de lidar com grandes bases de dados utiliza a sintaxe do R para a execução de comandos.

Revolution Analytics é uma empresa de software estatístico focada no desenvolvimento de versões "open-core" do software livre e open source para R. Revolution Analytics foi fundada em 2007 oferecendo apoio e serviços para o software R em um modelo semelhante a abordagem da Red Hat com Linux na década de 1990.

Um bom ponto de partida para entender o Revolution R é pesquisando nos fóruns: http://forums.revolutionanalytics.com/forums/forum.php.

Em 2009, a empresa recebeu nove milhões em capital da Intel, juntamente com uma empresa nomeando Norman H. Nie como seu novo CEO. Em 2010, a empresa anunciou a mudança de nome, bem como uma mudança de foco. Seu principal produto, Revolution R, seria oferecido gratuitamente aos usuários acadêmicos e seu software comercial iria incidir sobre grandes volumes de dados, utilizando multiprocessamento em larga escala e funcionalidade multi-core.

Formato XDF é o formato padrão no Revolution R.


Esse tipo de formato tem como principais características:

  • Armazena dados em blocos para a leitura eficiente de colunas arbitrárias e linhas contíguas.
  • Contém metadados associados, tais como nomes de variáveis​​, descrições e tipos de armazenamento de dados.
  • Suporta um conjunto mais rico de tipos de armazenamento de dados do que R (oito tipos de inteiros, dois tipos de números de ponto flutuante.
  • Escreve blocos de dados de linhas para que o processamento de dados possa ser otimizado.
  • Processa os dados em blocos (grupos de blocos).
  • Otimiza o tamanho dos blocos dependendo da largura de banda do computador individual para I/O.

Uma vez instalado o Revolution R o primeiro passo é criar um projeto:


O interessante é que no Revolution R podemos criar Soluções, Projetos e Scripts. Uma SOLUÇÃO pode conter mais de um PROJETO, e os projetos podem conter um ou mais SCRIPTS. A principal tela do Revolution R é a seguinte:


Suponha que desejamos importar o arquivo Pobreza.csv. Para importar os dados no ambiente Revolution R, basta inserirmos os Snippets. Clique com o botão direito do mouse na tela de Script e escolha:


Em seguida vá na Opção Data Sets:


Escolha a opção Import Data:


Automaticamente, o Revolution R cria a sintaxe básica para importação de dados. Para navegar entre os argumentos da função basta usar a tecla Tab:


Para executar o comando, basta fazer:


Observação: É importante indicar o endereço exato do arquivo Pobreza.csv, como por exemplo:

#Importação dos dados
pobreza.df<-read.table("C:/Pasta/Pobreza.csv",sep=",")

domingo, 13 de janeiro de 2013

Otimização de portfólio por meio do Random Matrix Theory.


A Teoria de Matrizes Aleatórias (Random Matrix Theory - RMT) pode ser utilizada em finanças com o intuito de "filtrar" o ruído presente nas estimativas das estatísticas de interesse como covariâncias e correlações. Essa abordagem tem se mostrado superior a otimização clássica de portifólios como sugerido por Daly, Crane e Ruskin (2007).

Teoria de Matrizes Aleatórias foi inicialmente desenvolvido por Dyson (1962) com o intuito de explicar os níveis de energia de núcleos complexos e tem sido amplamente utilizada no filtro do "ruído" presente em séries temporais financeiras, especialmente em sistemas de grandes dimensões como os mercados de ações.

A ideia é que uma vez que o número de observações e variabilidade são altas nos dados financeiros, as estimativas produzidas para a matriz de variâncias e covariâncias entre os retornos financeiros dos ativos está permeada de ruído e assim, o "verdadeiro" parâmetro pode estar mascarado, fornecendo portfólios sub-ótimos.

Assuma que as matrizes de correlação de variâncias e covariância podem ser expressas da seguinte forma:

$\mathbf{R}=\frac{1}{T}\mathbf{A}\mathbf{A}^{'}$

onde $A$ é uma matriz cujos elementos são independentes e identicamente distribuídos segundo uma $N(0,\sigma^{2})$, então Sengupta e Mitra (1999) mostraram que quando $N\rightarrow\infty$ e $T\rightarrow\infty$ tal que $Q=T/N\geq 1$ é fixado então a distribuição dos autovalores de $\mathbf{R}$ é dada por:

$P(\lambda)=\frac{Q}{2\pi\sigma^{2}}\frac{\sqrt{(\lambda_{+}-\lambda)(\lambda-\lambda_{-})}}{\lambda}$ se $\lambda_{-}\le\lambda\le\lambda_{+}$

onde $\sigma^{2}$ é a variância dos elementos de $\mathbf{A}$ e $\lambda_{\pm}=\sigma^{2}(1+1/Q \pm \sqrt{1/Q})$.

Nesse caso, as matrizes de dados históricos podem ser comparadas com as gerados a partir de retornos aleatórios. Então, somente os autovalores maiores ou iguais a $\lambda_{+}$ conteriam "informação" sobre o Mercado.

Considere os dados:

#Limpa o Workspace
rm(list=ls())

#Habilita o pacote quantmod
library(quantmod)

#Início do período de interesse
inicio = as.Date("2011-01-01") 

#Fim do período de interesse
fim = as.Date("2012-12-31") 

#Ativos
ativos<-c("AMBV4.SA","BBAS3.SA","BBDC4.SA","BISA3.SA","BRFS3.SA","BRKM5.SA","BTOW3.SA","BVMF3.SA","CESP6.SA","CIEL3.SA","CMIG4.SA","CPLE6.SA","CRUZ3.SA","CSAN3.SA","CSNA3.SA","CYRE3.SA","ELET3.SA","ELET6.SA","ELPL4.SA","EMBR3.SA","LIGT3.SA","LREN3.SA","MRFG3.SA","NATU3.SA","PCAR4.SA","PDGR3.SA","PETR3.SA","PETR4.SA","RDCD3.SA","RSID3.SA","SANB11.SA","TIMP3.SA","TRPL4.SA","UGPA3.SA","USIM3.SA","USIM5.SA","VALE3.SA","VALE5.SA")

#Força downloads no Yahoo Finance.
getSymbolsCont <- 
  function(tickers, from=NULL, to=Sys.Date(), src="yahoo") { 
    ok = FALSE 
    n = length(tickers) 
    i = 1 
    while(i <= n | !ok) { 
      
      print(tickers[i]) 
      
      sym = NULL 
      try ( sym <- getSymbols(tickers[i], from=from, to=to, src=src, 
                              auto.assign=FALSE)) 
      
      if(!is.null(sym)) { 
        assign(tickers[i], sym, envir = .GlobalEnv) 
        i = i+1 
        ok=TRUE 
      } else {ok=FALSE} 
      
      Sys.sleep(1) 
    } 
  } 

#Obtêm os dados
series.env <- new.env() 
getSymbolsCont(ativos, src="yahoo",from=inicio,to=fim)

#Une os dados
dados <- merge(AMBV4.SA,BBAS3.SA,BBDC4.SA,BISA3.SA,BRFS3.SA,BRKM5.SA,BTOW3.SA,BVMF3.SA,CESP6.SA,CIEL3.SA,CMIG4.SA,CPLE6.SA,CRUZ3.SA,CSAN3.SA,CSNA3.SA,CYRE3.SA,ELET3.SA,ELET6.SA,ELPL4.SA,EMBR3.SA,LIGT3.SA,LREN3.SA,MRFG3.SA,NATU3.SA,PCAR4.SA,PDGR3.SA,PETR3.SA,PETR4.SA,RDCD3.SA,RSID3.SA,SANB11.SA,TIMP3.SA,TRPL4.SA,UGPA3.SA,USIM3.SA,USIM5.SA,VALE3.SA,VALE5.SA)

#Dados Closing Price
dados.Cl<-Cl(dados)

#Calcula o log-retorno
dados.Cl<-na.omit(apply(dados.Cl,2,function(x)  diff(log(x))))
head(dados.Cl)
O próximo passo é construir a matriz de variâncias e covariância para os dados:
#Matriz de variâncias e covariâncias
R<-nrow(dados.Cl)*as.matrix(cov(dados.Cl))
Em seguida precisamos calcular $\lambda_{+}=\sigma^{2}(1+1/Q + \sqrt{1/Q})$:
#Lambda máximo
A<-as.numeric(chol(R))
A<-A[which(A>0)]
sigma2<-var(A)
Q<-nrow(dados.Cl)/ncol(dados.Cl)
lambda.p<-sigma2*(1+1/Q + sqrt(1/Q))
Nesse caso, fica evidente que há autovalores que são "ruídos" e autovalores "informativos". Laloux et. al. (2000) sugerem a seguinte abordagem: 1 - Calcule a matriz diagonal de autovalores da matriz de variâncias e covariâncias usando decomposição espectral. Nessa primeira etapa, a matriz de variâncias e covariâncias $\mathbf{V}$ pode ser escrita como $\mathbf{V}=\mathbf{E}\mathbf{\Lambda} \mathbf{E}^{-1}$, no R podemos fazer:
#Decomposição espectral
r <- eigen(R)
E <- r[[2]]
Lambda <- diag(r[[1]])
hist(r[[1]])
abline(v=lambda.p,col=3,lty=3)
which(r[[1]] < lambda.p)
2 - Na matriz $\mathbf{\Lambda}$ substitua os autovalores "ruído", ou seja, aqueles que são inferiores a $\lambda_{+}$ pela média de todos os autovalores "ruído" e mantenha os autovalores "informativos" os mesmos. Realizando essa etapa no R temos:
#Lambda Ruídos
iLambdas<-which(r[[1]] < lambda.p)
lambda.medio<-mean(r[[1]][iLambdas])
lambda.filtered<-r[[1]]
lambda.filtered[iLambdas]<-lambda.medio
Lambda.filtered<-diag(lambda.filtered)
3 - A matriz $\mathbf{\Lambda}_{filtrado}$ obtida no passo anterior é combinada novamente por meio da decomposição espectral na forma $\mathbf{V}_{filtrado}=\mathbf{E}\mathbf{\Lambda}_{filtrado} \mathbf{E}^{-1}$. Note que nessa abordagem o traço da matriz $\mathbf{V}_{filtrado}$ é igual a $\mathbf{V}$.
#Encontra a matriz de variâncias e covariâncias filtrada
R.filtered<-E%*%Lambda.filtered%*%solve(E)
4 - Constrói-se as carteiras usando então a matriz $\mathbf{V}_{filtrado}$. Nesse caso desejamos obter os pesos: $w_{i}=\frac{\displaystyle\sum_{j=1}^{n}\sigma_{ij}^{-1}}{\displaystyle\sum_{j,k}\sigma_{jk}^{-1}}$ que minimizam $\mbox{Min }W = \displaystyle\sum_{i,j}w_{i}w_{j}\sigma_{ij}$ onde $\sum_{i=1}^{n}w_{i}=1$ e $\mathbf{V}_{filtrado}^{-1}=\{\sigma_{ij}^{-1}\}$.
#Pesos para os ativos
R.inv<-solve(R.filtered)
pesos<-apply(R.inv,1,function(x)sum(x)/sum(R.inv))
pesos<-cbind(pesos,colnames(dados.Cl))

Abordagem de Plerou.

Plerou et. al. (2002) sugerem ao invés de substituir pela média os autovalores "ruído", substituir simplesmente por zero, e após obter a matriz filtrada na forma: $\mathbf{V}_{filtrado}=\mathbf{E}\mathbf{\Lambda}_{filtrado} \mathbf{E}^{-1}$

Corrigir a diagonal de $\mathbf{V}_{filtrado}$ na forma: $\mbox{diag}(\mathbf{V}_{filtrado})=\mbox{diag}(\mathbf{V})$

terça-feira, 27 de novembro de 2012

Programação Linear no R.


A programação linear possui muitas aplicações nas Ciências Sociais e Exatas.

Nesse post mostrarei como solucionar problemas de programação linear no R por meio da biblioteca lpSolveAPI.

Considere o seguinte problema de programação linear:


O primeiro passo no R para a resolução desse problema é invocar a biblioteca lpSolveAPI, para isso utilizamos o seguinte comando:

#Chama a biblioteca
library(lpSolveAPI)

Como o problema possui somente duas variáveis vamos criá-lo com o nome de modelo.lp1 inicialmente sem nenhuma restrição:

#Define a criação de um modelo com 0 restrições e 2 variáveis
modelo.lp1 <- make.lp(0, 2)

#Dá o nome ao problema de programação linear
name.lp(modelo.lp1, "Exemplo 1 - Aula de MMQD 1")
Note que o comando make.lp recebe dois argumentos, o primeiro informa quantas restrições existem no problema e o segundo quantas variáveis. Inicialmente, colocamos zero restrições pois iremos adicioná-las dinamicamente nos próximos passos. Já o comando name.lp recebe dois argumentos, o primeiro argumento é o objeto modelo.lp1 que nós criamos e o segundo é o nome (ou descrição) do problema. Uma vez definida as principais características do problema de programação linear precisamos definir o domínio das variáveis e o tipo de problema (maximização ou minimização). Como nosso problema é um problema de maximação, escrevemos:
#Define as características do modelo
lp.control(modelo.lp1, sense="max")
Nesse comando, atribuímos ao modelo.lp1 o sentido de Maximização (isso é sense=''max'') para a função objetivo. Caso desejássemos Minimizar ao invés de maximizar escreveríamos sense=''min''. Como a função objetivo é escrita na forma $Minimize: Z=5x_{1} +6x_{2}$ devemos informar ao R que os coeficientes da função objetivo são, $5$ e $6$ respectivamente. Isso é feito por meio da seguinte sintaxe:
#Define a função objetivo
set.objfn(modelo.lp1, c(5,6))
Em seguida, como o problema pode assumir valores $x_{1}\geq 0,x_{2}\geq 0$ atribuímos os seguintes limites para as variáveis de decisão:
#Define os limites da região factível
set.bounds(modelo.lp1, lower = c(0,0), upper = c(Inf, Inf))

#Tipo das variáveis de decisão
set.type(modelo.lp1, c(1,2), type = c("real"))
No comando set.bounds informamos que a primeira variável possui limite inferior (lower) igual a zero e limite superior (upper) igual a infinito (Inf). O mesmo fazemos para a segunda variável, nesse caso dizemos que o limite inferior (lower) é igual a zero e o limite superior (upper) é igual a infinito (Inf). A ordem aqui importa, ou seja, caso a primeira variável estivesse contida entre zero e infinito e a segunda variável estivesse contida entre os valores 1 e 4 deveríamos escrever set.bounds(modelo.lp1, lower = c(0,1), upper = c(Inf, 4)). O comando set.type define o tipo de variável para cada uma das variáveis de decisão. É possível escolher as seguintes opções:
  1. integer - A variável só pode assumir valores inteiros.
  2. binary - A variável só pode assumir valores binários, isso é, 1 ou zero.
  3. real - A variável pode assumir valores nos reais.
O comando set.type informa ao objeto modelo.lp1 que as variáveis $x_{1}$ e $x_{2}$ (c(1,2)) são números reais. Mas o comando anterior, set.bounds diz ao R que as variáveis devem estar entre 0 e $\infty$, portanto, $x_{1}\geq 0$ e $x_{2}\geq 0$. O passo 3 é responsável pela adição das restrições no problema de Programação Linear. Vamos então adicionar uma restrição de cada vez. A primeira restrição é dada por: $x_{1} \le 6$ a qual pode ser escrita na forma $ 1x_{1}+0x_{2} \le 6$. Assim, a adição dessa restrição no objeto modelo.lp1 é feita da seguinte forma:
#Define os coeficientes da primeira restrição
coef1 <- c(1,0)

#Adiciona a restrição
add.constraint(modelo.lp1, coef1, "<=", 6)
Para a segunda restrição $2x_{2} \le 12\Rightarrow 0x_{1}+2x_{2} \le 12$, a adição é feita da seguinte forma:
#Define os coeficientes da segunda restrição
coef2 <- c(0,2)

#Adiciona a restrição
add.constraint(modelo.lp1, coef2, "<=", 12)
Finalmente, a última restrição $3x_{1}+2x_{2}\le 18$ é adicionada fazendo-se:
#Define os coeficientes da terceira restrição
coef3 <- c(3,2)

#Adiciona a restrição
add.constraint(modelo.lp1, coef3, "<=", 18)
Uma vez que o problema tenha sido configurado, todas as informações associadas a ele estão armazenadas no objeto modelo.lp1. Podemos visualizar essas informações fazendo:
#Mostra as informações do modelo
print(modelo.lp1)
Podemos também visualizar esse problema, uma vez que é um problema bidimensional, isso é, contém somente duas variáveis de decisão:
#Plota a região factível
plot(modelo.lp1)
Finalmente, para resolvê-lo, fazemos:
#Resolve o problema primal
solve(modelo.lp1)
resultado<-get.primal.solution(modelo.lp1)
print(resultado)
Entretanto, como os resultados não estão em um formato muito explicativo, vamos transformá-los em uma tabela (isso é um data.frame) e colocar títulos nas linhas e nas colunas:
#Transforma o resultado em uma tabela
solucao<-as.data.frame(resultado)

#Coloca os nomes nas colunas e nas linhas da tabela
names(solucao)<-c("Valores")
rownames(solucao)<-c("Função Objetivo", "Variável de folga 1","Variável de folga 2",
"Variável de folga 3","Solução X1", "Solução X2")

#Mostra os resultados com os nomes
print(solucao)

quinta-feira, 22 de novembro de 2012

Causalidade e Correlação


Causalidade é a relação entre um evento (a causa) e um segundo evento (o efeito), em que o segundo acontecimento é entendida como uma consequência do primeiro.

No uso comum, a causalidade é também a relação entre um conjunto de fatores (causas) e um fenômeno (o efeito). Qualquer coisa que afete um efeito, é denominada fator desse efeito. Um fator direto é um fator que afeta diretamente o efeito, isto é, sem quaisquer fatores intervenientes.

Compreender a relação causa-efeitoentre as variáveis ​​é de interesse primordial em muitos campos da ciência. Normalmente, a intervenção experimental é utilizada para avaliar estas relações.

Entre os métodos comuns para a avaliação da cause e efeito destacam-se:

  1. Variáveis Instrumentais.
  2. Equações estruturais.
  3. Redes Bayesianas.
  4. Modelos Gráficos.

Pacote pcalg


Suponha que temos um sistema descrito por algumas variáveis ​​e muitas observações obtidas deste sistema. Além disso, suponha que seja plausível a não existência de variáveis faltantes (omissão de variáveis) e também que no sistema não apresenta loops de feedback do sistema causal subjacente.

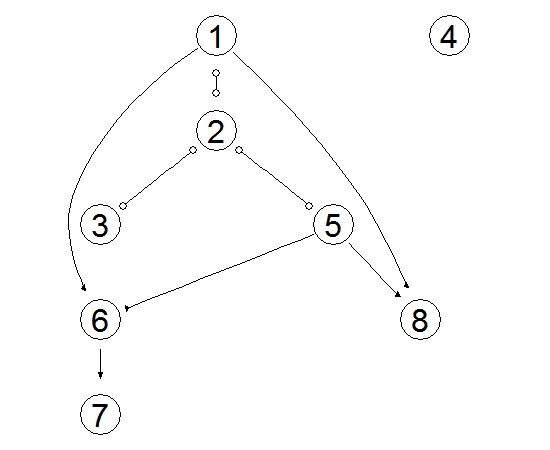
A estrutura causal de um sistema deste tipo pode ser convenientemente representado por um gráfico acíclico dirigido (DAG - Directed Acyclic Graph), em que cada nó representa uma variável e cada aresta representa uma causa direta.

Por exemplo, suponha o seguinte grafo:


Nesse exemplo, a variável 1 causa a variável 2 diretamente, ou seja é um fator direto para a variável 2 mas é um fator interveniente da variável 5.

Usualmente, não se conhece a relação entre as variáveis a não ser que algum modelo teórico seja desenvolvido para explicar a relação entre as variáveis, e mesmo nesse caso o modelo necessita ser validado.

O caso mais comum ocorre quando não há qualquer informação quanto ao comportamento causal dessas variáveis, nesse caso o objetivo é estimar essas relações e apresentar o grafo causal estimado.

Os modelos implementados no pacote pcalg são capazes de estimar o grafo causal das variáveis de uma base de dados mesmo que nenhum modelo seja conhecido a priori.

Os métodos implementados são o Algoritmo PC (Spirtes et al., 2000), Algoritmo FCI (Spirtes et al. ,1999), Algoritmo RFCI (Colombo et al., 2012) e o Método IDA (Maathuis et al., 2009).

Alguns pressupostos para cada um dos algoritmos implementados no pacote pcalg são apresentados abaixo:

  • Algoritmo PC: Nenhuma variável oculta existe ou deixou de ser selecionada.
  • Algoritmo FCI: Permite a existência de variável oculta ou omissão de variáveis.
  • Algoritmo RFCI: Permite a existência de variável oculta ou omissão de variáveis.
  • Método IDA: Nenhuma variável oculta existe ou deixou de ser selecionada.

Prática no R.


Antes de instalar o pacote pcalg no R é necessário instalar dois pacotes:


Para a representação de gráficos, o pacote pcalg utiliza dois outros pacotes chamados RBGL e o pacote graph.

Estes pacotes não estão disponíveis no CRAN, mas estão no outro repositório do software R, BioConductor.

Para instalá-los, siga as instruções abaixo:

#Instala os pacotes necessários.
source("http://bioconductor.org/biocLite.R") 
biocLite("RBGL")
biocLite("Rgraphviz")

Após a instalação desses pacotes, instale normalmente o pacote pcalg. Como exemplo utilizaremos dados simulados pelos autores do pacote pcalg.

Esses dados foram construídos de modo a possuírem a estrutura gráfica apresentada anteriormente. Aqui, realizaremos estimativas com base nos dados para avaliar se os métodos gráficos implementados no pcalg conseguem identificar corretamente a estrutura gráfica original.

Devemos inicialmente habilitar o pacote pcalg e em seguida ler o conjunto de dados que desejamos explorar:

#Habilita o pacote pcal
library("pcalg")

#Lê os dados simulados
dados.df<-read.csv("http://dl.dropbox.com/u/36068691/DadosPCALG.csv",sep=" ")
O primeiro método que utilizaremos é o Algoritmo PC:
#Gera as Estatísticas Suficientes
estatisticas  <-  list(C  =  cor(dados.df),  n  =  nrow(dados.df))

#Executa o Algoritmo PC
pc.fit  <-  pc(estatisticas,  indepTest  =  gaussCItest, p  =  ncol(dados.df),  alpha  =  0.01)

#Plota os resultados
plot(pc.fit,  main  =  "Algoritmo PC.")
Na primeira parte do comando a lista estatisticas armazena a Matriz de Correlações e o tamanho da amostra (número de observações na base). Essas informações são suficientes para a execução do Algoritmo PC. Em seguida a função pc(.) executa o Algoritmo PC. O comando "gaussCItest" testa a independência condicional assumindo que as variáveis possuem distribuição normal a um nível de significância de 0.01. O resultado obtido fornece o seguinte grafo:
Note que o grafo gerado está muito próximo da estrutura verdadeira, os desvios ocorrem devido ao tamanho amostral e flutuações estocásticas. Por exemplo, a relação entre as variáveis 1 e 6 foi apresentada corretamente, mas a relação entre as variáveis 1 e 2 apresenta uma relação bidirecional, o que não é verdade para os dados simulados. O próximo algoritmo a ser utilizado é o Algoritmo FCI. O Algoritmo FCI é uma generalização do Algoritmo PC, no sentido de permitir a existência de muitas possíveis variáveis latentes (omitidas) no modelo. A execução do Algoritmo FCI é similar ao do Algoritmo PC:
#Executa o Algoritmo FCI
fci.fit  <-  fci(estatisticas,  indepTest  =  gaussCItest, p  =  ncol(dados.df),  alpha  =  0.01)

#Plota os resultados
plot(fci.fit,  main  =  "Algoritmo FCI.")
O grafo obtido usando esse algoritmo foi:
Note que nesse caso, algumas relações foram identificadas mas a direção não pode ser estimada. Por exemplo, a variável 1 causa a variável 6, mas a relação entre a variável 1 e a variável 2 não pode ser identificada... A única informação que temos é que possivelmente as variáveis 1 e 2 se relacionam mas não sabemos como. Para o Algoritmo RFCI utilizamos a seguinte sintaxe:
#Executa o Algoritmo RFCI
rfci.fit  <-  rfci(estatisticas,  indepTest  =  gaussCItest, p  =  ncol(dados.df),  alpha  =  0.01)

#Plota os resultados
plot(rfci.fit,  main  =  "Algoritmo RFCI.")
O Algoritmo RFCI é similar ao Algoritmo FCI. No entanto, esse é mais rápido em sua execução. O grafo produzido, nesse caso, é idêntico ao Algoritmo FCI:
Por fim, o último algoritmo é o Método IDA. Esse método, diferente dos demais algoritmos mensura o grau de relação entre as variáveis. Por exemplo, se desejamos saber qual o grau de efeito entre as variáveis 1 e 6 (variável 1 causando a variável 6) utilizamos o seguinte código:
#Executa o Método IDA para o Algoritmo PC
ida(1, 6, cov(dados.df), pc.fit@graph)
O comando retorna os seguintes valores [0.7536376 0.5487757]. Isso significa que a magnitude do efeito da variável 1 sobre a variável 6 é algum valor nesse intervalo. Uma vez que ambos os valores são maiores do que zero, podemos concluir que a variável 1 apresenta um efeito positivo causal sobre a variável 6. Esses valores refletem o efeito do aumento em uma unidade na variável 1 em relação a variável 6. Em alguns casos quando se conhece determinadas relações entre as variáveis, é possível fixar relações e permitir que os algoritmos busquem apenas as relações de causalidade desconhecidas, nesses casos utiliza-se os comandos fixedGaps e fixedEdges.


terça-feira, 13 de novembro de 2012

Modelos de mediação.


Em muitos campos da ciência o objetivo dos pesquisadores não é apenas estimar o efeito causal de um tratamento, mas também a compreensão do processo no qual o tratamento afeta o resultado de maneira causal.

A análise de mediação causal é frequentemente usada para avaliar os potenciais mecanismos causais.

Estudiosos de diversas disciplinas estão cada vez mais interessados ​​em identificar mecanismos causais, indo além da estimativa dos efeitos causais e explorando por completo o modelo causal.

Uma vez que certas variáveis foram identificadas como responsáveis pelo efeito causal associado a um determinado resultado, o próximo passo é entender como essas variáveis ​​exercem influência.

Nesses casos, o procedimento padrão para analisar os mecanismos causais na pesquisa aplicada é chamada análise de mediação. Nessas análises um conjunto de modelos de regressão, são ajustados e, em seguida, as estimativas dos "efeitos de mediação" são calculados a partir dos modelos ajustados (por exemplo, Haavelmo 1943; Baron e Kenny 1986; Shadish, Cook e Campbell 2001; MacKinnon 2008).

Pacote mediation.


O pacote de mediation do R permite aos usuários:

  1. Investigar o papel dos mecanismos causais utilizando diferentes tipos de dados e modelos estatísticos.
  2. Explorar como os resultados mudam quando os pressupostos são relaxados (análise de sensibilidade).
  3. Calcular medidas de interesse em diversos projetos de pesquisa.

A prática corrente na análise de mediação atualmente são inferências baseadas em modelos. Em um delineamento experimental, a variável tratamento é randomizada e as variáveis de mediação e os resultados são observados.

Imai et ai. (2010) mostram que uma gama de modelos paramétricos e semi-paramétrico podem ser utilizados para estimar o efeito médio causal média e mediação causal e outras quantias de interesse.

Aplicação usando o pacote mediation.

Para ilustrar o procedimento utilizaremos como exemplo os dados obtidos por Brader, Valentino e Suhat (2008).

Brader et al. (2008) conduziram um experimento casualizado onde os indivíduos foram expostos a diferentes histórias sobre a imigração. O objetivo era investigar como o seu enquadramento os influencia as atitudes e comportamentos políticos em relação à política de imigração.

#Habilita o pacote mediation
library("mediation")

#Lê os dados
dados.df<-read.csv("http://dl.dropbox.com/u/36068691/dadosMediacao.csv")
Os autores postularam a ansiedade (variável emo) como variável mediadora do efeito causal para o enquadramento na opinião pública. O primeiro passo é ajustar o modelo de mediação para a medida de ansiedade (variável emo), essa é modelada como uma função da variável tratamento (treat) e co-variáveis ​​de pré-tratamento como (idade - age, educ, gênero - gender e renda - income).
# Modelo de mediação
med.fit <- lm(emo ~ treat + age + educ + gender + income, data = dados.df)
Em seguida, modelamos a variável resultado, a qual é uma variável binária que indica se o participante concordou em enviar uma carta sobre a política de imigração ao seu membro do Congresso (variável cong_mesg). As variáveis ​​explicativas do modelo incluem a variável de mediação, a variável de tratamento, e o mesmo conjunto de variáveis de pré-tratamento ​​como as utilizadas no modelo de mediação.
# Modelo para o resultado
out.fit <- glm(cong_mesg ~ emo + treat + age + educ + gender + income, data = dados.df, family = binomial("probit"))
Neste exemplo, espera-se que o tratamento aumente a resposta emocional dos entrevistados, que por sua vez é postulado fazer com que os respondentes sejam mais propensos a enviar uma carta ao seu membro do Congresso. Inicialmente usamos um modelo de regressão linear e regressão de probit para os modelos de mediação e o modelo para o resultado, respectivamente. Vamos agora usar o modelo de mediação para estimar os efeitos médios causais diretos (ACME - Average Causal Mediation effects). Para isso, basta executar o seguinte código:
#Habilita o pacote sandwich
library(sandwich)

#Estima os efeitos médios
med.out <- mediate(med.fit, out.fit, treat = "treat", mediator = "emo", robustSE = TRUE)

#Apresenta as estimativas
summary(med.out)
Como argumentos para esta função, é necessário especificar os modelos (neste caso, med.fit e out.fit), bem como o nome da variável de tratamento e da variável de mediação, que são representados como treat = "treat" e mediator = "emo", respectivamente. Além disso, usamos a matriz de variâncias e covariâncias robustas para a heterocedasticidade oriunda do pacote de sandwich. Ao executar o comando, o seguinte resultado surge:
Nesse exemplo, utilizou-se 1000 simulações para que o erro-padrão das estimativas fossem obtidos. Neste exemplo, os efeitos médios causais diretos (ACME - Average Causal Mediation effects) estimados são estatisticamente significantes e portanto, diferentes de zero, mas as estimativas dos efeitos diretos para médio e total não são. Em outras palavras, os resultados sugerem que o tratamento no ensaio pode ter aumentado a resposta emocional, que por sua vez tornou os indivíduos mais propensos a enviar uma mensagem ao seu congressista. Aqui, uma vez que a variável resultado é binária todos os efeitos estimados são expressos como uma alteração na probabilidade do respondente enviar uma mensagem ao Congresso. O pacote mediation apresenta outras opções como a possibilidade de análises gráficas, análises por segmentos e múltiplas entradas. Para maiores detalhes veja Tingley et. al (2012).

quinta-feira, 8 de novembro de 2012

Otimização de portfólio.


O pacote do R denominado Tawny fornece uma maneira simples para otimizar carteiras de investimento de forma a minimizar o risco em uma carteira.

Este otimizador pode executar a otimização de carteiras para diversos períodos temporais simultaneamente.

A ideia é: "não colocar todos os seus ovos em uma mesma cesta".

Para fins de ilustração, considere um subconjunto de ativos do S&P 500. Abaixo estão os códigos em R para otimizar a carteira de investimentos:

#Habilita a biblioteca Tawny 
library(tawny)

#Lê o subconjunto de dados do S&P 500
data(sp500.subset)
dados <- create(TawnyPortfolio, sp500.subset, window=190)

# Otimizando por meio de uma janela temporal de tamanho 190
pesos <- optimizePortfolio(dados, create(SampleFilter) )

terça-feira, 18 de setembro de 2012

Teste de razão de variâncias de Lo-MacKinlay.


Existem muitos textos que sugerem através de evidências empíricas que o retorno de ações contém componentes que podem ser preditos.

Por exemplo, Keim e Stambaugh (1986) encontraram um modelo estatisticamente significante para prever o preço de ações usando um modelo de previsão com variáveis pré-determinadas.

Fama e French (1987) mostraram que um longo período de retenção de retornos é negativamente correlacionado serialmente, implicando assim que 25% a 40% da variação de um longo período de retornos é previsível com base nos retornos passados.

Esse post, no entanto, tem como objetivo principal apresentar o Teste de Razão de Variâncias proposto por Lo e MacKinlay (1988). Os autores indicam que o modelo de passeio aleatório (ou passeio do bebâdo) é, em geral, inconsistente (para os ativos estudados) com o comportamento estocástico dos retornos semanais, especialmente para as ações com menor capitalização (Small Caps).

Lo e MacKinlay (1988) alertam que estes resultados não implicam necessariamente que o mercado de ações é ineficiente ou que os preços das ações não são avaliações racionais dos seus valores "fundamentais". O teste proposto pelos autores pode ser interpretado como um teste para a rejeição de "algum" modelo econômico de formação eficiente de preços.

Teste de razão de variâncias.

A eficiência do mercado de ações tem sido debatida por pesquisadores e profissionais do mercado financeiro. Uma forma particular de eficiência do mercado de ações é a eficiência informacional.

A eficiência informacional se baseia na premissa de que os preços dos ativos refletem as informações relevantes disponíveis instantaneamente aos investidores e ao público em geral. Como a chegada de informações é imprevisível, os preços dos ativos também se tornam imprevisíveis. A hipótese de que a chegada de informações fundamentais ao mercado é aleatória e, portanto, os movimentos dos preços dos ativos também serão aleatórios, é englobada pela teoria do passeio aleatório dos preços dos ativos.

De maneira simplista, a teoria do passeio aleatório indica que uma vez que a chegada de informações é imprevisível, o melhor preditor do preço de um ativo é seu valor atual. Esta ideia simples pode ser facilmente incorporada no modelo de passeio aleatório bem conhecido dos preços dos ativos, que pode ser expresso da seguinte forma: $P_{t}=P_{t-1}+\epsilon$.

$P_{t}$ é o preço atual do ativo em estudo, $P_{t-1}$ é o preço do período anterior, e $\epsilon$ é um termo de erro aleatório. Cada termo de erro aleatório representa a chegada de uma nova informação, o qual se assumido ser imprevisível deve ser independentes uns dos outros. Admitindo sobre a hipótese nula o termo de erro aleatório é independente e identicamente distribuído segundo uma distribuição normal, então a variância do termo de erro aleatório é linear no intervalo de tempo durante o qual os preços são observados. Simplesmente, a variância da variação de preços quinzenais deve ser o dobro da variação de preços semanais. Além do mais, a variância das alterações de preços mensais deve ser quatro vezes superior ao de alterações de preços semanais, e assim por diante.

A relação linear entre o intervalo de tempo observado para os preços do ativo de interesse e a sua variação é a essência da especificação do teste desenvolvido por Lo e MacKinlay (1988). Lo e MacKinlay (1988) desenvolveram distribuições limitantes para os estimadores de razão de variância, com e sem a existência de heterocedasticidade, e mostraram que os preços dos ativos não necessariamente seguem um passeio aleatório. Seus estimadores são definidos como se segue:

A equação (01) representa a média das alterações dos preços em T períodos de tempo:


Já a equação (02) representa um estimador de variância para as alterações dos preços no period de tempo especificado, isso é $t=1,\dots,T$:


Por fim, a equação (03) representa um estimador de variância para as mudanças q-temporais de preços:


e $m=q(T-q+1)(1-\frac{q}{T})$ é um ajuste executado no denominador da variância do estimador q-temporal para acomodar as observações que se sobrepõem, além de ajudar a aumentar a potência do teste de razão de variância.

Especificação do teste.


Assim, o teste da razão de variâncias é definido por:


Para acomodar a possível heterocedasticidade, utiliza-se a estatística do teste padronizado $z$ o qual é assintoticamente distribuído segundo uma normal padrão:


onde


e


Aplicação usando os dados da Bovespa


Utilizando o R, vamos calcular o teste de razão de variâncias de Lo e MacKinlay para as ações PETR4 em um período $q=1$ diário, isso é, com defasagem de um dia.

#Limpa o console
rm(list=ls(all=TRUE))

#Habilita o pacote quantmod
library(quantmod)

#Início do período de interesse
start = as.Date("2011-01-01") 

#Fim do período de interesse
end = as.Date("2011-12-31") 

#Obtêm os dados da PETR4
getSymbols("PETR4.SA", src="yahoo",from=start,to=end)

A seguir é necessário calcular os log-retornos de duas séries: a série original e a série defasada (nesse caso em um dia):

#Aplica o log-retorno nos preços
ret <- as.matrix(c(rep(NA, 0), diff(log(Cl(PETR4.SA)), lag=1)))

#Aplica o log-retorno nos preços (Defasagem diária)
ret2 <- as.matrix(c(rep(NA, 0), diff(log(Cl(PETR4.SA)), lag=2)))
#Plota a série temporal dos preços de fechamento
plot(ret, main="Petr4",type="l",
+ylab="Log-return Close price. (Lag 1)",xlab="Time")

plot(ret2,main="Petr4",type="l",
+ylab="Log-return Close price. (Lag 2)",xlab="Time")
Em seguida os parâmetros exigidos para o teste são calculados:
#Calcula muhat
muhat <- mean(ret, na.rm=TRUE)
nq <- nrow(ret)
#Parâmetros Sigma e Delta
sigatop <- (ret - muhat)^2
sigatop1 <- c(NA, sigatop[-length(sigatop)])
deltop <- sigatop * sigatop1
delbot <- sigatop
sigctop <- (ret2 - 2*muhat)^2
#Guarda os resultados
dados <- data.frame(ret, sigatop, sigatop1, deltop, delbot, sigctop)
Fazendo a soma, obtemos os valores desejados:
#Calcula a soma dos valores
sigatop <- sum(sigatop, na.rm=TRUE)
sigctop <- sum(sigctop, na.rm=TRUE)
deltop <- sum(deltop, na.rm=TRUE)
delbot <- sum(delbot, na.rm=TRUE)
Em seguida o cálculo dos testes é realizado:
nq<-nrow(ret)
q<-2
qm1<-q-1
theta<-0
j<-1
m <- q*(nq-q+1)*(1-q/nq)
siga <- sigatop/(nq-1)
sigc <- sigctop/m
varrat2 <- sigc/siga
delta <- nq*deltop/(delbot**2)
while(j <= qm1)
{
  theta <- theta + ((2*(q-j)/q)**2)*delta
  j<-j+1
}

z <- sqrt(nq)*(varrat2-1)/sqrt(theta)
print(nq, cat("Número de retornos:"))
print(varrat2, cat("Razão de variâncias para retronos com Lag=2:"))
print(z, cat("Teste Robusto a Heterocedasticidade de Lo-MacKinlay:"))
Após realizar a análise obtêm-se:
  • Número de retornos:[1] 249
  • Razão de variâncias para retronos com Lag=2:[1] 1.081269
  • Teste Robusto a Heterocedasticidade de Lo-MacKinlay:[1] 1.052326
Os resultados indicam que a hipótese nula de presença de um comportamento como um passeio aleatório para a série PETR4 diária entre 01-01-2011 até 31-12-2011 não pode ser rejeitada, uma vez que o valor do teste não é maior do que o valor crítico sobre a hipótese nula, qual seja, aproximadamente 1.96 a um nível de confiança de 95%. Uma maneira direta de se atingir o mesmo resultado é por meio da biblioteca vrtest. A função que realiza o teste de Lo-MacKinlay é a função Lo.Mac(y=, kvec=) onde o parâmetro y= recebe o vetor de ativos e kvec= a defasagem utilizada no teste.

sábado, 8 de setembro de 2012

Calculando a função densidade de probabilidade da distribuição estável usando FFT.


Distribuições estáveis ​​paretianas têm propriedades atraentes para modelagem empírica em finanças, porque incluem a distribuição normal como um caso especial, mas também pode permitir caudas mais pesadas e assimetria.

Uma razão principal para a pouca utilização dessa distribuição em trabalhos acadêmicos aplicados é devido ao fato de que, em geral, não há expressão de "forma fechada" para a a função de densidade de probabilidade, e que as aproximações numéricas computacionais são não-triviais e computacionalmente extensivas.

Nesse post vou mostrar como é possível calcular a função densidade de probabilidade via Fast-Fourier Transform (FFT).

O trabalho original sobre esse assunto foi produzido por Mittnik, Doganoglu e Chenyao (1999).

A distribuição alfa-estável.


A distribuição alfa-estável, em geral, não possui expressão analítica para sua função densidade de probabilidade (f.d.p) ou ainda para a sua função distribuição acumulada (f.d.a), mas pode ser escrita por meio de sua função característica (Rachev e Mittnik, 2000 ):


onde $0<\alpha<2$ é o expoente da distribuição ou índice de cauda, $-1\le \beta\le 1$ é o parâmetro de assimetria, $\sigma>0$ é o parâmetro de escala e $\delta \in \Re$ é o parâmetro de locação, a função $\omega(.,.)$ é dada por:


A distribuição alfa-estável representada acima e definida pela notação $S_{\alpha}^{0}(\beta,\delta,\sigma)$ é denominada parametrização $S_{0}$ segundo Nolan (2010).

A função densidade de probabilidade pode ser aproximada utilizando o método FFT (Fast Fourier Transform) o qual é computacionalmente eficiente e permite um processo de aproximação mais rápido do que expansão por séries (Bergström, 1952) ou integração direta (Nolan, J. P., 2001. Maximum likelihood estimation of stable parameters. Manuscrito não publicado.).

Segundo Durrett (2010) página 106 uma função densidade de probabilidade pode ser escrita pela Transformada de Fourier da função característica, em outras palavras:


A integral acima pode ser calculada para $n$ pontos igualmente espaçados com distância $h$ e soma resultante pode ser computada por meio do método FFT (Fast Fourier Transform). Mittnik e Doganoglu (1999) sugerem que os valores de $n$ e $h$ devem ser respectivamente $2^{13}$ e $h=0.01$ para que uma boa aproximação seja possível.

Implementação no R.


Podemos então implementar o método descrito anteriormente no R.

Inicialmente, definimos os valores dos parâmetros para os quais desejamos calcular a função densidade de probabilidade:

#Limpa o console
rm(list=ls(all=TRUE))

#Parâmetros para o calculo da PDF
alpha<-0.5
beta<-0.3
sigma<-1
delta<-0
O limite superior para o suporte da distribuição $xmax$ e o número de pontos utilizados para a aproximação $n$ deve ser definido:
#Valor máximo em módulo da PDF
xmax<-20

#2^N espaços iguais entre [-xmax,xmax]
n<-13
Devido à natureza do método FFT, valores distantes do centro da distribuição podem ser subestimados. Por esta razão o método aqui sugerido calcula a função densidade de probabilidade da distribuição alfa-estável para o intervalo $[-xmax, xmax] \times 2^{mult}$ onde o multiplicador $mult$ é utilizado para aumentar (temporariamente) o suporte da distribuição, em seguida, esse intervalo aumentado é truncado em seu intervalo original. Seja o valor $mult=4$ como uma primeira tentativa, no entanto, para melhor precisão deve-se utilizar $mult>4$.
#Define o multiplicador
mult<-4

#Calcula o intervalo do suporte aumentado
xmax <- xmax*(2^mult)

#Aumenta n para cobrir o intervalo maior com os mesmos pontos do grid
n <- n + mult
M <- 2^n
R <- pi/xmax
dt <- 1/(R*M)
Como o método FFT admite a utilização de números complexos e devido a função característica da distribuição alfa-estável possuir número imaginário na sua estrutura precisamos definí-lo no R:
#Número imaginário
i<-complex(real = 0, imaginary = 1)

#Define o grid de valores com pontos uniformemente espaçados 
xx <-seq(from = -2^(n-1)+0.5, to = (2^(n-1)-0.5))/(2^n*dt)
Em seguida, a função característica é definida:
#Função característica da distribuição alfa-estável
piby2 <- pi/2
if(abs(alpha-1)<0.001)
  {
    yy <- exp( -sigma*(abs(xx))*( 1+i*beta*sign(xx)/piby2*log(sigma*abs(xx))) + i*delta*xx )
  }
else
{
    yy <- exp( -(sigma*abs(xx))^alpha*( 1+i*beta*sign(xx)*tan(alpha*piby2)*( (sigma*abs(xx))^(1-alpha)-1 ) ) + i*delta*xx )
}
Note que caso $\alpha$ esteja muito próximo de um, admitimos que $\alpha=1$ e utilizamos a estrutura da função característica nessa condição. O próximo passo é aplicar o método FFT:
#Utiliza o método FFT
yy1 <- c(yy[seq(from=(2^(n-1)+1),to=2^n)], yy[seq(from=1,to=2^(n-1))])
z <- Re( fft(yy1) )/(2*pi)*R
E após a utilização do método FFT pela função fft do R, a função densidade de probabilidade é calculada:
#Computa a função densidade de probabilidade
x <- (2*pi)*(seq(from=0,to=(M-1),by=1)/(M*R)-1/(2*R))
y <- c(z[seq(from=(2^(n-1)+1),to=2^n)], z[seq(from=1,to=2^(n-1))])
Por fim, o intervalo original do suporte da distribuição é obtido e o esboço de sua função densidade de probabilidade é apresentado:
#Encontra os pontos da f.d.p no intervalo original
T <- which((x<=xmax/(2^mult)) & (x>=-xmax/(2^mult)))
x <- x[T]
y <- y[T]

#Plota a função densidade de probabilidade
plot(x,y,type="l", main ="Distribuição alfa-estável"
+,xlab="Suporte",ylab="f.d.p",col="blue")
O valor da função densidade de probabilidade para um ponto arbitrário qualquer pode ser obtido por meio de interpolação entre os pontos que contém o valor desejado. Já a aproximação via FFT para outras parametrizações segue o mesmo processo, exceto pela definição da expressão da função característica na sintaxe apresentada anteriormente que deve ser alterada para a parametrização desejada.