SAUDAÇÕES!

Seja bem vindo à página do professor Pedro Albuquerque. Para saber mais sobre meu currículo, disciplinas ministradas e interesses de pesquisa, navegue no menu disponível no topo da página.
Mostrando postagens com marcador Econometria. Mostrar todas as postagens

domingo, 13 de janeiro de 2013

Otimização de portfólio por meio do Random Matrix Theory.


A Teoria de Matrizes Aleatórias (Random Matrix Theory - RMT) pode ser utilizada em finanças com o intuito de "filtrar" o ruído presente nas estimativas das estatísticas de interesse como covariâncias e correlações. Essa abordagem tem se mostrado superior a otimização clássica de portifólios como sugerido por Daly, Crane e Ruskin (2007).

Teoria de Matrizes Aleatórias foi inicialmente desenvolvido por Dyson (1962) com o intuito de explicar os níveis de energia de núcleos complexos e tem sido amplamente utilizada no filtro do "ruído" presente em séries temporais financeiras, especialmente em sistemas de grandes dimensões como os mercados de ações.

A ideia é que uma vez que o número de observações e variabilidade são altas nos dados financeiros, as estimativas produzidas para a matriz de variâncias e covariâncias entre os retornos financeiros dos ativos está permeada de ruído e assim, o "verdadeiro" parâmetro pode estar mascarado, fornecendo portfólios sub-ótimos.

Assuma que as matrizes de correlação de variâncias e covariância podem ser expressas da seguinte forma:

$\mathbf{R}=\frac{1}{T}\mathbf{A}\mathbf{A}^{'}$

onde $A$ é uma matriz cujos elementos são independentes e identicamente distribuídos segundo uma $N(0,\sigma^{2})$, então Sengupta e Mitra (1999) mostraram que quando $N\rightarrow\infty$ e $T\rightarrow\infty$ tal que $Q=T/N\geq 1$ é fixado então a distribuição dos autovalores de $\mathbf{R}$ é dada por:

$P(\lambda)=\frac{Q}{2\pi\sigma^{2}}\frac{\sqrt{(\lambda_{+}-\lambda)(\lambda-\lambda_{-})}}{\lambda}$ se $\lambda_{-}\le\lambda\le\lambda_{+}$

onde $\sigma^{2}$ é a variância dos elementos de $\mathbf{A}$ e $\lambda_{\pm}=\sigma^{2}(1+1/Q \pm \sqrt{1/Q})$.

Nesse caso, as matrizes de dados históricos podem ser comparadas com as gerados a partir de retornos aleatórios. Então, somente os autovalores maiores ou iguais a $\lambda_{+}$ conteriam "informação" sobre o Mercado.

Considere os dados:

#Limpa o Workspace
rm(list=ls())

#Habilita o pacote quantmod
library(quantmod)

#Início do período de interesse
inicio = as.Date("2011-01-01") 

#Fim do período de interesse
fim = as.Date("2012-12-31") 

#Ativos
ativos<-c("AMBV4.SA","BBAS3.SA","BBDC4.SA","BISA3.SA","BRFS3.SA","BRKM5.SA","BTOW3.SA","BVMF3.SA","CESP6.SA","CIEL3.SA","CMIG4.SA","CPLE6.SA","CRUZ3.SA","CSAN3.SA","CSNA3.SA","CYRE3.SA","ELET3.SA","ELET6.SA","ELPL4.SA","EMBR3.SA","LIGT3.SA","LREN3.SA","MRFG3.SA","NATU3.SA","PCAR4.SA","PDGR3.SA","PETR3.SA","PETR4.SA","RDCD3.SA","RSID3.SA","SANB11.SA","TIMP3.SA","TRPL4.SA","UGPA3.SA","USIM3.SA","USIM5.SA","VALE3.SA","VALE5.SA")

#Força downloads no Yahoo Finance.
getSymbolsCont <- 
  function(tickers, from=NULL, to=Sys.Date(), src="yahoo") { 
    ok = FALSE 
    n = length(tickers) 
    i = 1 
    while(i <= n | !ok) { 
      
      print(tickers[i]) 
      
      sym = NULL 
      try ( sym <- getSymbols(tickers[i], from=from, to=to, src=src, 
                              auto.assign=FALSE)) 
      
      if(!is.null(sym)) { 
        assign(tickers[i], sym, envir = .GlobalEnv) 
        i = i+1 
        ok=TRUE 
      } else {ok=FALSE} 
      
      Sys.sleep(1) 
    } 
  } 

#Obtêm os dados
series.env <- new.env() 
getSymbolsCont(ativos, src="yahoo",from=inicio,to=fim)

#Une os dados
dados <- merge(AMBV4.SA,BBAS3.SA,BBDC4.SA,BISA3.SA,BRFS3.SA,BRKM5.SA,BTOW3.SA,BVMF3.SA,CESP6.SA,CIEL3.SA,CMIG4.SA,CPLE6.SA,CRUZ3.SA,CSAN3.SA,CSNA3.SA,CYRE3.SA,ELET3.SA,ELET6.SA,ELPL4.SA,EMBR3.SA,LIGT3.SA,LREN3.SA,MRFG3.SA,NATU3.SA,PCAR4.SA,PDGR3.SA,PETR3.SA,PETR4.SA,RDCD3.SA,RSID3.SA,SANB11.SA,TIMP3.SA,TRPL4.SA,UGPA3.SA,USIM3.SA,USIM5.SA,VALE3.SA,VALE5.SA)

#Dados Closing Price
dados.Cl<-Cl(dados)

#Calcula o log-retorno
dados.Cl<-na.omit(apply(dados.Cl,2,function(x)  diff(log(x))))
head(dados.Cl)
O próximo passo é construir a matriz de variâncias e covariância para os dados:
#Matriz de variâncias e covariâncias
R<-nrow(dados.Cl)*as.matrix(cov(dados.Cl))
Em seguida precisamos calcular $\lambda_{+}=\sigma^{2}(1+1/Q + \sqrt{1/Q})$:
#Lambda máximo
A<-as.numeric(chol(R))
A<-A[which(A>0)]
sigma2<-var(A)
Q<-nrow(dados.Cl)/ncol(dados.Cl)
lambda.p<-sigma2*(1+1/Q + sqrt(1/Q))
Nesse caso, fica evidente que há autovalores que são "ruídos" e autovalores "informativos". Laloux et. al. (2000) sugerem a seguinte abordagem: 1 - Calcule a matriz diagonal de autovalores da matriz de variâncias e covariâncias usando decomposição espectral. Nessa primeira etapa, a matriz de variâncias e covariâncias $\mathbf{V}$ pode ser escrita como $\mathbf{V}=\mathbf{E}\mathbf{\Lambda} \mathbf{E}^{-1}$, no R podemos fazer:
#Decomposição espectral
r <- eigen(R)
E <- r[[2]]
Lambda <- diag(r[[1]])
hist(r[[1]])
abline(v=lambda.p,col=3,lty=3)
which(r[[1]] < lambda.p)
2 - Na matriz $\mathbf{\Lambda}$ substitua os autovalores "ruído", ou seja, aqueles que são inferiores a $\lambda_{+}$ pela média de todos os autovalores "ruído" e mantenha os autovalores "informativos" os mesmos. Realizando essa etapa no R temos:
#Lambda Ruídos
iLambdas<-which(r[[1]] < lambda.p)
lambda.medio<-mean(r[[1]][iLambdas])
lambda.filtered<-r[[1]]
lambda.filtered[iLambdas]<-lambda.medio
Lambda.filtered<-diag(lambda.filtered)
3 - A matriz $\mathbf{\Lambda}_{filtrado}$ obtida no passo anterior é combinada novamente por meio da decomposição espectral na forma $\mathbf{V}_{filtrado}=\mathbf{E}\mathbf{\Lambda}_{filtrado} \mathbf{E}^{-1}$. Note que nessa abordagem o traço da matriz $\mathbf{V}_{filtrado}$ é igual a $\mathbf{V}$.
#Encontra a matriz de variâncias e covariâncias filtrada
R.filtered<-E%*%Lambda.filtered%*%solve(E)
4 - Constrói-se as carteiras usando então a matriz $\mathbf{V}_{filtrado}$. Nesse caso desejamos obter os pesos: $w_{i}=\frac{\displaystyle\sum_{j=1}^{n}\sigma_{ij}^{-1}}{\displaystyle\sum_{j,k}\sigma_{jk}^{-1}}$ que minimizam $\mbox{Min }W = \displaystyle\sum_{i,j}w_{i}w_{j}\sigma_{ij}$ onde $\sum_{i=1}^{n}w_{i}=1$ e $\mathbf{V}_{filtrado}^{-1}=\{\sigma_{ij}^{-1}\}$.
#Pesos para os ativos
R.inv<-solve(R.filtered)
pesos<-apply(R.inv,1,function(x)sum(x)/sum(R.inv))
pesos<-cbind(pesos,colnames(dados.Cl))

Abordagem de Plerou.

Plerou et. al. (2002) sugerem ao invés de substituir pela média os autovalores "ruído", substituir simplesmente por zero, e após obter a matriz filtrada na forma: $\mathbf{V}_{filtrado}=\mathbf{E}\mathbf{\Lambda}_{filtrado} \mathbf{E}^{-1}$

Corrigir a diagonal de $\mathbf{V}_{filtrado}$ na forma: $\mbox{diag}(\mathbf{V}_{filtrado})=\mbox{diag}(\mathbf{V})$

sábado, 5 de janeiro de 2013

Redes neurais no R: Aplicações em finanças.


Uma rede neural artificial, muitas vezes chamada apenas de rede neural, é um modelo matemático inspirado pelas redes neurais biológicas.

Uma rede neural consiste em um grupo de neurônios artificiais interligados e processa a informação através de uma abordagem conexionista à computação. Na maioria dos casos, uma rede neural é um sistema adaptável, que muda a sua estrutura durante uma fase de aprendizagem.

As redes neurais são usadas para modelar relações complexas entre entradas e saídas ou para encontrar padrões em dados.

Considere, por exemplo, a órbita dos planetas em torno do sol ou o calendário das mares.

A ideia central do aprendizado de máquina é:

"Pode-se usar o computador para descobrir e descrever padrões baseados em dados ?"

De maneira formal, a hipótese básica do aprendizado de máquina é a Hipótese de Aprendizagem Indutiva:

Uma função adequada encontrada para modelar a função alvo para um conjunto suficientemente grande de dados também irá funcionar para modelar adequadamente exemplos não observados.

Isso quer dizer que se encontrarmos alguma "boa fórmula" para o movimento dos planetas em torno do sol, por exemplo, e que essa fórmula tenha sido construída com base em uma amostra suficientemente grande, espera-se que essa "boa fórmula" funcione bem "out-of-sample".

Nesse post mostrarei como usar o pacote neuralnet com uma aplicação a finanças.

Pacote neuralnet.

O pacote neuralnet foi construído de forma a ser possível trabalhar com Perceptron Multi-camadas (multi-layer perceptrons) no contexto da análise de regressão, isto é, para aproximar as relações funcionais entre variáveis independentes e variáveis resposta.

Assim, as redes neurais podem ser utilizadas como extensões do modelo linear generalizado.

Uma das vantagens do pacote neuralnet é a possibilidade de poder se trabalhar com um número arbitrário de covariáveis e​​ também de variáveis ​​de resposta, assim como o número de camadas ocultas.

Redes neurais.

Em muitas situações, a relação funcional entre as covariáveis ​​(também conhecidas como variáveis ​​de entrada ou variáveis independentes) e as variáveis ​​de resposta (também conhecidas como variáveis ​​de saída ou variáveis dependentes) é de grande interesse.

As redes neurais artificiais podem ser aplicadas como aproximação a qualquer relação funcional complexa.

Ao contrário dos modelos lineares generalizados (McCullagh e Nelder, 1989), não é necessário que o tipo de relação entre variáveis ​​dependentes e variáveis ​​resposta seja, por exemplo, uma combinação linear.

Isso faz das redes neurais artificiais uma valiosa ferramenta quantitativa. Esses modelos são, particularmente, extensões diretas dos modelos lineares generalizados e podem ser aplicados de maneira semelhante.

Dados observados são usados ​​para treinar a rede neural, fazendo assim com que a rede neural "aprenda" uma aproximação da relação entre as variáveis independentes e dependentes de forma iterativa por meio da adaptação contínua dos seus parâmetros. De fato, usando a nomenclatura estatística, os parâmetros do modelo são estimados por meio da amostra.

Perceptron Multi-Camadas.

O pacote neuralnet se concentra nos modelos Perceptron Multi-Camadas (Multi-Layer Perceptrons (MLP))(Bishop, 1995), os quais são úteis na modelagem por meio de relações funcionais entre as variáveis.

A estrutura subjacente de um MLP é um grafo orientado, isto é, consiste de vértices (neurônios) e arestas (sinapses).

Os neurônios são organizados em camadas, que são normalmente ligadas por sinapses. No pacote neuralnet, uma sinapse só pode se conectar a camadas posteriores.

A camada de entrada é constituída por todas as covariáveis (um neurônio para cada covariável) separadas por neurônios (camadas ocultas) até as variáveis ​​resposta.

Essas camadas intermédias são denominadas camadas ocultas (ou variáveis latentes), por não serem diretamente observáveis​​.

As camadas de entrada e as camadas ocultas incluem um neurônio constante, o qual estará associado ao intercepto em modelos lineares, ou seja, não é diretamente influenciado por qualquer covariável.


A figura anterior retirada de Günther e Fritsch (2010) representa um exemplo de uma rede neural com dois neurônios de entrada (A e B) e um neurônio de saída (Y), além de uma camada oculta composta de três neurônios.

Um peso (parâmetro) está associado a cada uma das sinapses, representando o efeito correspondente do neurônio e de todos os dados passam pela rede neural como sinais.

Os sinais são processados ​​inicialmente pela função de integração combinando todos os sinais de entrada e, em seguida, pela função de ativação transformando os resultados do neurônio.

O modelo perceptron multicamada mais simples consiste de uma única camada de entrada com $n$ covariáveis ​e uma camada de saída com um único neurônio de saída. Esse modelo calcula a seguinte função:


onde $w_{0}$ denota o intercepto, $\mathbf{w} = (w_{1},\dots, w_{n})$ o vetor de todos os demais pesos (parâmetros), e $\mathbf{x} = (x_{1},\dots, x_{n})$ o vetor de todas as covariáveis.

A função é matematicamente equivalente à estrutura padrão do modelo linear generalizado com função de ligação $f^{-1}(.)$. Portanto, todos os pesos calculados são, neste caso, equivalentes aos parâmetros da regressão via MLG.

Para aumentar a flexibilidade da modelagem mais camadas ocultas podem ser incluídas, aumentando assim a "não-linearidade" do modelo. No entanto, Hornik et al. (1989) mostraram que uma única camada oculta é suficiente para modelar qualquer função contínua por partes.

O modelo perceptron multicamada com uma camada oculta consistindo de $J$ neurônios calcula a seguinte função:


onde $w_{0}$ denota o intercepto do neurônio de saída e $w_{0j}$ representa o intercepto do $j$-ésimo neurônio oculto. Além disso, $w_{j}$ denota o peso sináptico correspondente à sinapse começando no $j$-ésimo neurônio oculto e que conduz ao neurônio de saída. $\mathbf{w_{j}} = (w_{1j},\dots, w_{nj})$ o vetor de todos os pesos sinápticos correspondentes às sinapses que conduzem ao $j$-ésimo neurônio oculto, e $\mathbf{x} = (x_{1},\dots, x_{n})$ é o vetor de todas as covariáveis.

Apesar das redes neurais serem extensões diretas dos MLG, os parâmetros não podem ser interpretados da mesma maneira.

De maneira formal, todos os neurônios ocultos e os neurônios de saída calculam a seguinte função: $f(g(z_{0},z_{1},\dots, z_{k})) = f(g(\mathbf{z}))$ a partir das saídas de todos os neurônios precedentes $z_{0}, z_{1},\dots, z_{k}$, onde $g:\mathbb{R}^{k+1}\rightarrow \mathbb{R}$ representa a função de integração e $f:\mathbb{R}\rightarrow \mathbb{R}$ é a função de ativação. O neurônio unitário $z_{0}$ é uma constante o qual está relacionado com o conceito de intercepto em modelos de regressão.

A função de integração é, muitas vezes, definida como $g(\mathbf{z})= w_{0}z_{0} + \sum_{i=1}^{n}w_{i}z_{i}= w0 + \mathbf{w}^{'}\mathbf{z}$. A função de ativação $f$ é geralmente uma função não-linear, não-decrescente, limitada e também diferenciável tal como o função logística $f(u) = 1/(1+\exp^{-u})$ ou a tangente hiperbólica.

Essa função deve ser escolhida em relação à variável de resposta, assim como nos modelos lineares generalizados. A função logística é, por exemplo, apropriada para variáveis ​​resposta binárias, uma vez que mapeia a saída de cada neurônio para o intervalo $[0,1]$. O pacote neuralnet usa a mesma função de integração, bem como função de ativação para todos os neurônios.

Aprendizado supervisionado.


As redes neurais são estimadas por meio de um processo de treinamento da rede que usa os dados para "aprender". Especificamente, o pacote neuralnet concentra-se em algoritmos de aprendizado supervisionado.

Estes algoritmos de aprendizagem são caracterizados pela utilização de saídas (outputs, resultados ou ainda variáveis dependentes), as quais são comparadas com o valor predito pela rede neural, adaptando dinamicamente os valores dos parâmetros de modo que o "erro" seja minimizado.

Os parâmetros de uma rede neural são os seus pesos. Todos os pesos são geralmente iniciados com valores aleatórios provenientes de uma distribuição normal padrão. Durante um processo iterativo de formação da rede, as seguintes etapas são repetidas:


  • A rede neural calcula uma saída de $o(\mathbf{x})$ para as entradas dadas $\mathbf{x}$ e para os parâmetros correntes (pesos atuais). Se o processo de formação ainda não estiver concluído, os resultados previstos serão diferentes da saída $\mathbf{y}$ observada.
  • Uma função de erro, como a Soma dos Quadrados dos Erros (SSE - Sum of Squared Errors):
    ou a entropia cruzada:

    mede a diferença entre a saída prevista e o resultado observado, tal que $l=1,\dots,L$ representam os índices para as observações, ou seja, é o par ordenado com os dados de entrada e saída, e $H=1,\dots,H$ representam os nós de saída.
  • Todos os pesos são adaptados segundo alguma regra de aprendizagem definida a priori.

O processo termina se um critério pré-determinado é atingido, por exemplo, se todas as derivadas parciais da função de erro com respeito aos pesos $(\partial E/\partial \mathbf{w})$ são menores do que um dado limiar. Um algoritmo de aprendizagem amplamente utilizado é o algoritmo resilient backpropagation.

Resilient backpropagation.


O algoritmo resilient backpropagation é baseado no algoritmo de retropropagação tradicional, o qual modifica os pesos de uma rede neural, a fim de encontrar um mínimo local para a função de erro estipulada.

Em outras palavras, o gradiente da função de erro $(\partial E /\partial\mathbf{w})$ é calculado em relação aos pesos, a fim de encontrar uma raiz. Particularmente, os pesos são modificadas para irem na direção oposta das derivadas parciais até que um mínimo local seja atingido.

Esta ideia básica é aproximadamente ilustrada na figura abaixo retirada do texto de Günther e Fritsch (2010), para uma função de erro univariada:


Caso a derivada parcial seja negativa, o peso é aumentado (lado esquerdo da figura) e se a derivada parcial for positiva, o peso é reduzido (parte da direita da figura). Isto garante que um mínimo local para a função de erro seja atingido.

Todas as derivadas parciais são calculadas usando a regra da cadeia, desde que a função do cálculo de uma rede neural seja basicamente uma composição de funções de integração e ativação. Uma explicação detalhada é dada em Rojas (1996).

O pacote neuralnet possibilita a escolha do método entre o clássico backpropagation e o resilient backpropagation, com retrocesso do peso (Riedmiller, 1994) ou sem retrocesso de peso (Riedmiller e Braun, 1993) e também a versão modificada globalmente proposta por Anastasiadis et al. (2005).

Aplicação em finanças.

A aplicação de redes neurais em finanças não é nova. Wonga e Selvib (1998) apresentam uma ampla revisão da utilização de redes neurais em finanças entre os anos 1990 a 1996. Os autores investigaram a tendência de aplicações produzidas no período 1990-1996. Wonga e Selvib (1998) analisaram a literatura de acordo com os seguintes critérios: (1) ano de publicação, (2) área de aplicação, (3) domínio do problema, (4) fase do processo de decisão, (5) nível de gestão (6), nível de interdependência de tarefas, (7) meios de desenvolvimento, (8) de interação corporativa / acadêmica, (9) Tecnologia / técnica estatística, e (10) estudo comparativo.

Yoon e Swales (1991) apresentam uma discussão sobre a previsibilidade dos preços de ações por meio de redes neurais. Segundo os autores, a previsão do desempenho do preço de ações é um problema difícil e complexo. Técnicas multivariadas quantitativas e qualitativas têm sido repetidamente usadas para auxiliar na formação da expectativas dos investidores quanto aos preços de ações. Yoon e Swales (1991) analisaram a capacidade das redes neurais e seu poder de previsão em contraste com o método de análise discriminante.

Nesse post farei uma breve aplicação do método de redes neurais com o intuito de avaliar o poder de previsibilidade das ações por meio dessa ferramenta.

Inicialmente, vamos obter a série temporal (01/01/2001 a 31/12/2012) para o ativo PETR4.SA por meio do pacote quantmod:

#Limpa o Workspace
rm(list=ls())

#Habilita o pacote quantmod
library(quantmod)

#Início do período de interesse
inicio = as.Date("2001-01-01") 

#Fim do período de interesse
fim = as.Date("2012-12-31") 

#Obtêm os dados da PETR4
getSymbols("PETR4.SA", src="yahoo",from=inicio,to=fim)

Nesse caso, queremos tentar construir um preditor na forma de um Modelo Autoregressivo de ordem 5, isto é:

$y_{t}=\phi_{0}+\phi_{1}y_{t-1}+\phi_{2}y_{t-2}+\phi_{3}y_{t-3}+\phi_{4}y_{t-4}+\phi_{5}y_{t-5}$

Nesse caso, o valor da ação no tempo $t$ seria predita pelos $5$ valores (diários) que a antecedem:

#Dados para o neuralnet
t0<-as.numeric(Cl(PETR4.SA))            #Cinco dias antes
t0<-t0[-((length(t0)-4):length(t0))]

t1<-as.numeric(Cl(PETR4.SA)) [-1]       #Quatro dias antes
t1<-t1[-((length(t1)-3):length(t1))]

t2<-as.numeric(Cl(PETR4.SA)) [-c(1,2)]  #Três dias antes
t2<-t2[-((length(t2)-2):length(t2))]

t3<-as.numeric(Cl(PETR4.SA)) [-(1:3)]   #Dois dias antes
t3<-t3[-((length(t3)-1):length(t3))]

t4<-as.numeric(Cl(PETR4.SA)) [-(1:4)]   #Um dia antes
t4<-t4[-length(t0)]

t5<-as.numeric(Cl(PETR4.SA)) [-(1:5)]   #Variável dependente
Em seguida vamos dividir a série temporal em duas partes:
  1. Período de estimação (01/01/2001 até 31/12/2006).
  2. Período de validação (01/01/2007 até 31/12/2012).
#Cria a base
dados<-cbind(t1,t2,t3,t4,t5)

#Dados para estimação:
dados.Treina<-dados[1:1457,]

#Dados para validação
dados.Valida<-dados[1458:2917,]
Usando os dados para estimação e trabalhando com um modelo de redes neurais com 1 camada com 7 neurônios e admitindo o número máximo de iterações igual a 10000 e valor de corte (threshold) igual 1, a programação para estimar os parâmetros da rede é:
set.seed(12345)
library("neuralnet")
maxit<-as.integer(1000000)
nn <- neuralnet(dados.Treina[,5]~dados.Treina[,4]+
+dados.Treina[,3]+dados.Treina[,2]+dados.Treina[,1],
+data=dados.Treina, hidden=7,threshold =1,stepmax= maxit)
onde o comando fixa a semente para a geração de números aleatórios com o intuito de permitir a reprodução dos resultados obtidos.
CUIDADO!!
A programação acima pode demorar para ser concluída, por isso, use com parcimônia os valores do número máximo de iterações e parâmetro threshold.
Uma vez obtidos os valores para os parâmetros do modelo de redes neurais podemos analisar os resultados usando os comandos:
#Apresenta os valores para os pesos
nn$result.matrix

#Faz o gráfico do modelo
plot(nn)
O próximo passo é realizar a previsão para os dados de validação:
#Faz a previsão
previsao<-compute(nn,dados.Valida[,1:4])

#Valores da previsao
previsao.nn<-previsao$net.result
Outra hipótese bastante comum para as séries temporais financeiras é a Hipótese do Passeio Aleatório a qual pode ser representada matematicamente como: $y_{t}=\mu+y_{y-1}+\epsilon_{t}$ Assumindo que $\epsilon_{t}\sim N(0,\sigma^{2})$ podemos utilizar os dados de treinamento para estimar os parâmetros desse modelo:
#Gera as estimativas para o Random Walk
epsilon<-(dados.Treina[,5]-dados.Treina[,4])
mu<-mean(epsilon)
sigma2<-var(epsilon)

#Faz a previsao usando o Random Walk
previsao.rw<-dados.Valida[,4]+rnorm(nrow(dados.Valida),
+mu,sqrt(sigma2))
O gráfico comparativo entre a previsão via redes neurais e Passeio Aleatório contra os valores observados é elaborado usando o seguinte código:
#Monta a base com as previsões
Tempo<-seq(1458,2917)
previsao.todos<-as.data.frame(cbind(
+Tempo,dados.Valida[,5],previsao.nn,previsao.rw))
colnames(previsao.todos)<-c("Tempo","Obsevado",
+"Predito.NN", "Predito.RW")

#Faz o gráfico
#Faz o gráfico
library("ggplot2")
ggplot(previsao.todos, aes(Tempo)) + 
  geom_line(aes(y = Obsevado, colour = "Obsevado")) + 
  geom_line(aes(y = Predito.NN, colour = "Predito NN"))+
  geom_line(aes(y = Predito.RW, colour = "Predito RW"))+
  ggtitle("Séries Temporais")
É interessante notar que o modelo de Passeio Aleatório se ajustou melhor aos valores observados do que o modelo de redes neurais, especialmente quando a volatilidade apresentada era grande. Comparando a distribuição dos erros entre os dois métodos temos:
#Encontra os erros
erro.rw<-previsao.todos[,2]-previsao.todos[,4]
erro.nn<-previsao.todos[,2]-previsao.todos[,3]

#Une os dados
library("reshape")
df.m <- melt(cbind(erro.rw,erro.nn))

#Calcula as funções densidade via Kernel.
ggplot(df.m) + geom_density(aes(x = value,colour = X2)) 
+ labs(x = "Valores",y="Densidade") +
ggtitle("Densidade por meio do estimador Kernel.")
O gráfico de densidades demonstra que o modelo Passeio Aleatório apresenta menos variabilidade na previsão do que o modelo de redes neurais. Uma proposta seria incorporar ao modelo de redes neurais alguma covariável associada a volatilidade e comparar novamente os resultados ou ainda, adicionar mais camadas ocultas no modelo com o intuito de aumentar a não-linearidade.

quinta-feira, 27 de setembro de 2012

Previsão de Séries Temporais usando Holt Winters.


Usualmente, quado desejamos fazer previsão há uma série de informações sobre o mercado que deveríamos levar em conta. Por exemplo, as vendas de produtos são muitas vezes sazonais, e podemos esperar que as tendências sejam sustentadas por períodos curtos, os quais podem se alterar.

Se temos por exemplo um produto inovador bem-sucedido, as vendas aumentarão inicialmente, mas depois estabilizarão antes de decrescer devido aos concorrentes que entram no mercado. Esse tipo de informação pode ser adequadamente modelada pelo método Holt-Winters.

A nomenclatura usada aqui define a mudança no nível de um período de tempo para o período seguinte, como inclinação (slope). Os padrões sazonais também podem mudar devido aos caprichos da moda e da variação do clima.

O método de Holt-Winters foi sugerido por Holt (1957) e Winters (1960), que
trabalharam no School of Industrial Administration em Carnegie Institute
of Technology
.

O método usa médias móveis ponderadas exponencialemente para atualizar as estimativas da média ajustada sazonalmente (chamada de nível), inclinação e sazonalidade.

Considere uma série temporal $\{x_{t}\}$ com período igual a $p$. O método Holt-Winters utiliza as seguintes equações:


onde $a_{t}$, $b_{t}$ e $s_{t}$ são as estimativas para o nível, inclinação e efeito da sazonalidade no período $t$. Os parâmetros $\alpha$, $\beta$ e $\gamma$ são os parâmetros de suavização.

A previsão para valores futuros $x_{n+k}$ em $k$ períodos a frente após a $n$-ésima observação é dada da seguinte forma:


onde $a_{n}$ é o nível estimado, $b_{n}$ é a inclinação estimada e $a_{n}+kb_{n}$ é o nível estimado no tempo $n+k$ e $s_{n}+k-p$ é a estimativa do peso exponencializado para o efeito sazonal no tempo $n=k-p$. Outra forma do método Holt-Winters é com efeito sazonal multiplicativo. Nesse caso, o conjunto de equações é dado por:


A equação de previsão para o período $x_{n} + k$ torna-se:


Os parâmetros podem ser fixados no R ou então estimados de modo a minimizar o erro de previsão. Em outras palavras, quando os parâmetros não são informados, o R procura pelos valores que minimizam o erro de previsão.

Usando o método Holt-Winters no R.

Para realizar a estimação e posterior previsão pelo método Holt-Winters no R utilizamos a função HoltWinters.

Para esse exemplo, considere a base de dados das concentrações atmosféricas de CO2 expressos em partes por milhão (ppm).

O nome da base em CSV é denominada BaseCO2.csv.

O primeiro passo é ler a base de dados no R:

#Lê a base de dados
dados.df<-read.csv("http://dl.dropbox.com/u/36068691/BaseCO2.csv")

#Imprime as variáveis existentes
names(dados.df)

#Cria a série temporal
serie<-ts(dados.df$CO2,start=c(1959,1),end=c(1997,12),frequency=12)
Os dados também foram transformados no formato ts com a primeira observação referente a Janeiro de 1959 e a última em Dezembro de 1997. O argumento frequency=12 informa ao R que cada período (de um ano) é composto por 12 observações. Em outras palavras, informa ao R que a frequência da série é mensal. Em seguida utilizamos a função HoltWinters:
#Realiza o método Holt-Winters
holt <- HoltWinters(serie)

#Plota a série temporal
plot(holt)

#Plota a decomposição da serie
plot(fitted(holt))
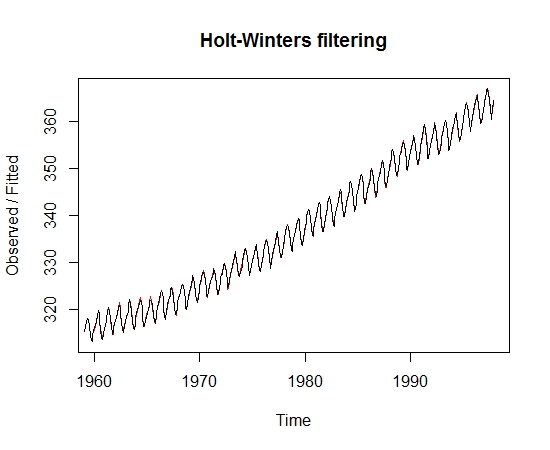
A série temporal observada juntamente com seus valores preditos pelo modelo são representados no gráfico abaixo:
O método decompõem a série temporal. Essa decomposição é apresentada a seguir:
A previsão para o próximo ano com um intervalo de confiança de 95% é dado pelo seguinte comando:
#Realiza a previsão para 12 meses a frente
p <- predict(holt, 12, prediction.interval = TRUE, level = 0.95)
plot(holt, p)
Cujo resultado é apresentado pelo gráfico abaixo:
Caso não haja sazonalidade evidente, podemos fazer:
#Realiza o método Holt-Winters sem efeito sazonal
holt <- HoltWinters(serie, gamma = FALSE)
Para maiores detalhes do método Holt-Winters indico o texto The Holt-Winters Forecasting Procedure.

quarta-feira, 5 de setembro de 2012

Testes de eventos usando o pacote quantmod.


O objetivo principal do Estudo de Eventos é mensurar o efeito de um determinado evento sobre o valor da firma.

Abaixo seguem os passos para a análise e inferência em Estudo de Eventos ( Campbell et. al., 1996 pág. 151):

  1. Defina o evento de interesse e identifique o período nos quais o preço do ativo poderia ser afetado, esse intervalo é denominado Janela do Evento.
  2. Após identificar o evento de interesse é necessário determinar quais são os critérios de seleção para incluir ativos de empresas. O critério pode envolver restrições impostas pelos dados (ex:. Empresas listadas na Bovespa) ou podem envolver restrições associadas ao setor econômico da empesa (ex:. Indústrias)
  3. Calcule os retornos anormais, esses retornos anormais são os retornos do ativo de interesse após o evento focal menos o retorno normal (predito) para a firma na janela de estimação. Matematicamente, $\epsilon_{t}=r_{it}-\mathbb{E}(r_{it}|\mathcal{F}_{t})$ onde $\epsilon_{t},r_{it}$ e $\mathbb{E}(r_{it}|\mathcal{F}_{t})$ são os retornos anormais, atuais e normais respectivamente para o período de tempo $t$ e $\mathcal{F}_{t}$ é o conjunto informacional disponível no tempo $t$. Usualmente, os modelos mais utilizados para o preditor $\mathbb{E}(r_{it}|\mathcal{F}_{t})$ são: Constant Mean Return Model ($\mathbb{E}(r_{it}|\mathcal{F}_{t})=\mu$) e Market Model ($\mathbb{E}(r_{it}|\mathcal{F}_{t})=\alpha+\beta r_{mt}$ onde $r_{mt}$ é o retorno do mercado.)
  4. Usando uma janela de estimação (antes do fato) os parâmetros do modelo são estimados. Usualmente, o período do evento focal não é incluído na janela de estimação para evitar que o evento influencie o nível normal dos retornos.
  5. Com base nas estimativas dos parâmetros o retorno anormal é calculado. A hipótese nula e as estratégias de agregação dos retornos são definidas.
  6. Resultados empíricos, interpretação e conclusão são então apresentados.

Visualmente, as janelas são descritas pelo seguinte gráfico:

Como exemplo, vamos considerar como evento a influência do Steve Jobs sobre o ativo da Apple.

Uma pergunta que surge é: O afastamento do Steve Jobs da Apple até o seu falecimento afetaram o preço das ações da Apple ?

Será que uma pessoa pode incorporar valor à organização ? E se pode, quanto é esse valor ?

Vamos testar esse evento utilizando a abordagem clássica de Campbell et. al., 1996 que apesar de amplamente muito utilizada apresenta alguns pressupostos inautênticos (Corrado, 2011).

Definiremos a janela do evento a saída do Steve Jobs da presidência da Apple (17/01/2011) até a data do seu falecimento (05/10/2011).

Como janela de estimação utilizaremos a mesma quantidade de dias compreendidos entre 17/01/2011 a 05/10/2011, dessa forma o primeiro passo é obter a série temporal dos preços da Apple:

#Habilita o pacote quantmod
library(quantmod)

#Cria um novo ambiente para armazenar os dados
stockData <- new.env() 

#Steve Jobs deixa a presidência da Apple
startEvent = as.Date("2011-01-17") 

#Steve Jobs falece
endEvent = as.Date("2011-10-05") 
#Quantidade de dias entre a saida e o falecimento.
tamanhoJanela<-endEvent-startEvent

#Início da série
startDate<-startEvent-tamanhoJanela

#Obtêm os dados da Apple
getSymbols("AAPL", src="yahoo",from=startDate,to=endEvent)
Podemos plotar a série temporal completa (03/05/2010 até 05/10/2011):
#Plota a série temporal dos preços de fechamento
plot.xts(Cl(AAPL),major.format="%b/%d/%Y",
+main="Apple",ylab="Close price.",xlab="Time")
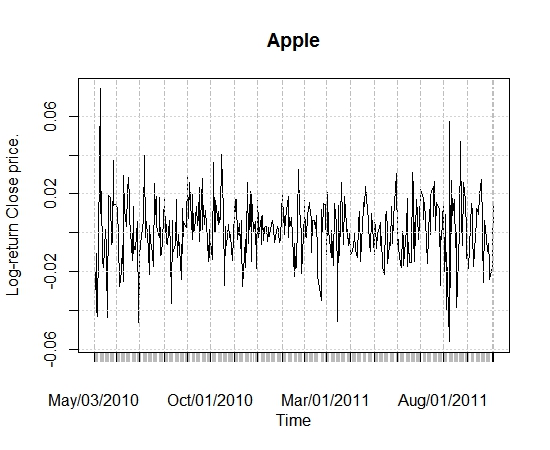
Usualmente, trabalhamos o log-retorno do ativo $r_{t}=log(R_{t})-log(R_{t-1})$:
#Calcula o log-retorno.
diffAAPL<-diff(log(AAPL))

#Plota a série temporal dos preços de fechamento
plot.xts(Cl(diffAAPL),major.format="%b/%d/%Y",
+main="Apple",ylab="Log-return Close price.",xlab="Time")
Agora precisamos estimar os retornos normais, utilizando o NASDAQ-100 como retorno do mercado, podemos estimar os parâmetros utilizando o modelo de mercado:
#Janela de estimação
AAPLSubset<-  window(diffAAPL, start = startDate, end = startEvent-1)

#Nasdaq-100
getSymbols("^NDX", src="yahoo",from=startDate,to=endEvent)
diffNDX<-diff(log(NDX))
NDXSubset<-window(diffNDX, start = startDate, end = startEvent-1)

#Estima o modelo de mercado
MarketModel<-lm(Cl(AAPLSubset)~Cl(NDXSubset))
summary(MarketModel)
As estimativas obtidas são $\hat{\alpha}=0.0007294$ e $\hat{\beta}=1.0297346$ aplicando a equação para toda a série, temos:
#Aplica o Market Model
epsilon<-diffAAPL-coef(MarketModel)[1]-coef(MarketModel)[2]*diffNDX

#Encontra a variância do epsilon
NDXSubset1<-na.omit(window(diffNDX, start = startDate+1,
+ end = startEvent-1))

X<-as.matrix(cbind(rep(1,length(Cl(NDXSubset1))),Cl(NDXSubset1)))
NDXSubset2<-window(diffNDX, start = startEvent, end = endEvent)

Xstar<-as.matrix(cbind(rep(1,length(Cl(NDXSubset2))),Cl(NDXSubset2)))

V<-(diag(nrow(X))*var(residuals(MarketModel)))+
+((X%*%solve(t(Xstar)%*%Xstar)%*%t(X))*var(residuals(MarketModel)))
Acumulamos agora o retorno na Janela do Evento usando o CAR (Cumulative Abnormal Return) e o SCAR (Standardized Cumulative Abnormal Return):
epsilonStar<-window(epsilon, start = startEvent, end = endEvent)
CAR<-sum(Cl(epsilonStar))
SCAR<-CAR/sqrt(sum(V))
Usando a abordagem clássica, a estatística SCAR possui distribuição t de Student com $L_{1}-2$ graus de liberdade onde $L_{1}=T_{1}-T_{0}$ nesse caso:
#Valor crítico da distribuição T
alpha<-0.05
df<-length(Cl(AAPLSubset))-2
qt(alpha/2,df)
qt(1-(alpha/2),df)

Como a estatística não recai sobre a região crítica a um nível de significância de 5%, então não rejeitamos a hipótese nula, qual seja: Nulidade do efeito Steve Jobs sobre as ações da Apple.

quarta-feira, 29 de agosto de 2012

Value at Risk (VaR) usando o R.

Em matemática financeira e gestão de risco financeiro, a medida Value at Risk (VaR) é uma medida de risco utilizada para mensurar o risco de perda de uma determinada carteira de ativos financeiros.

O VaR é definido como um valor limite tal que a probabilidade de perda daquele valor para a carteira ao longo do horizonte de tempo for superior a este valor de risco o qual é o nível de probabilidade determinado.

Por exemplo, se uma carteira de ações tem um VaR de um dia de 5% igual a 1 milhão de reais, há uma probabilidade de 0,05 de que a carteira caia a um valor superior 1 milhão de reais em um período de um dia.

O VaR tem quatro principais usos em finanças: gestão de riscos, controle financeiro e relatórios financeiros. VaR é por vezes utilizado em aplicações não-financeiras também.

Segundo Alexander (2009) os principais métodos de estimação do VaR são:

  • NFHS: Normal Filtered Historical Simulation.
  • STFHS: Student´s T Filtered Historical Simulation.
  • NEVT: Normal Extreme Value.
  • STEVT: Student´s T Extreme Value.

Considere o ativo PETR4 da Petrobrás para o ano de 2011 (01/01/2011 até 31/12/2011):

#Habilita o pacote quantmod
library(quantmod)

#Cria um novo ambiente para armazenar os dados
stockData <- new.env() 
#Especifica as datas de interesse
startDate = as.Date("2011-01-01") 
endDate = as.Date("2011-12-31")
#Obtêm os dados do ativo PETR4 e PETR3
getSymbols("PETR4.SA", src="yahoo",from=startDate,to=endDate)
#Calcula o log-retorno
retorno<-na.omit(diff(log(Cl(PETR4.SA))))
Para o método NFHS com $\lambda=0.05$ tem-se:
#Estima o VaR pelo método NFHS (lambda=0.05)
library(fGarch)
lambda<-0.05
#Passo1: Encotrando os resíduos padronizados
fit<-arima(retorno,order=c(1,0,0))
fit.res<-resid(fit)
modelo.N.FHS <- garchFit( ~garch(1, 1), fit.res , cond.dist = "norm")
sresi<-(modelo.N.FHS@residuals/modelo.N.FHS@sigma.t) 
#Passo2: Obtem-se sigma_t+1 e mu_t+1
mu.t1<- predict(fit, n.ahead=1)$pred[1]
sigma.t1<-predict(modelo.N.FHS , n.ahead=1)[1,1]
#Passo3: Para o período t+1 gera-se um conjunto de Retornos
uniforme<-ceiling(runif(1000)*length(sresi))
Retornos<-(sresi[uniforme]*sigma.t1)+mu.t1
#Passo4: Calcular o VaR
VaR.t1<- -quantile(Retornos, lambda) 
VaR.t1
O valor do $VaR_{0.05}=0.0006525116$ o que significa que com base nos dados da PETR4 entre 01/01/2011 até 31/12/2011 a probabilidade de se obter um retorno menor do que 0.06% é de 5%. Usando o método STFHS:
#Estima o VaR pelo método STFHS (lambda=0.05)
library(fGarch)
lambda<-0.05
#Passo1: Encotrando os resíduos padronizados
fit<-arima(retorno,order=c(1,0,0))
fit.res <- resid(fit)
modelo.N.FHS <- garchFit( ~garch(1, 1), fit.res , cond.dist = "sstd")
sresi<-(modelo.N.FHS@residuals/modelo.N.FHS@sigma.t) 
#Passo2: Obtem-se sigma_t+1 e mu_t+1
mu.t1<- predict(fit, n.ahead=1)$pred[1]
sigma.t1<-predict(modelo.N.FHS , n.ahead=1)[1,1]
#Passo3: Para o período t+1 gera-se um conjunto de Retornos
uniforme<-ceiling(runif(1000)*length(sresi))
Retornos<-(sresi[uniforme]*sigma.t1)+mu.t1
#Passo4: Calcular o VaR
VaR.t1<- -quantile(Retornos, lambda)
VaR.t1
O valor do VaR obtido aqui aproximadamente igual ao obtido pelo método NFHS $VaR_{0.05}=0.0006524376$ o que significa que com base nos dados da PETR4 entre 01/01/2011 até 31/12/2011 a probabilidade de se obter um retorno menor do que 0.06% é de 5%. Utilizando a abordagem paramétrica de valores extremos, temos para o método NEVT:
#Estima o VaR pelo método NEVT (lambda=0.05)
library(fGarch)
lambda<-0.05

#Passo1: Encotrando os resíduos padronizados
fit<-arima(retorno,order=c(1,0,0))
fit.res <- resid(fit)
modelo.N.EVT <- garchFit( ~garch(1, 1), fit.res , cond.dist = "norm")
sresi<-(modelo.N.EVT@residuals/modelo.N.EVT@sigma.t) 
#Passo2: Obtem-se sigma_t+1 e mu_t+1
mu.t1<- predict(fit, n.ahead=1)$pred[1]
sigma.t1<-predict(modelo.N.EVT , n.ahead=1)[1,1]
#Passo3: Estima o quantil com base na distribuição GEV
library(fExtremes)
sresi.menos<- -sresi
MLE<- gevFit(sresi.menos,type="pwm")
xi<- MLE@fit$par.ests[1]
mu<- MLE@fit$par.ests[2]
sigma<- MLE@fit$par.ests[3]

#Passo4: Calcular o VaR
quantil<- qgev(lambda, xi = xi, mu = mu, beta = sigma, lower.tail = TRUE)
VaR.t1<- -(mu.t1+quantil[1]*sigma.t1)
VaR.t1
O VaR obtido para o método NEVT foi de $0.0006521597$ e a interpretação é análoga aos exemplos anteriores. Por fim, o cálculo do VaR usando o método STEVT:
#Estima o VaR pelo método STEVT (lambda=0.05)
library(fGarch)
lambda<-0.05

#Passo1: Encotrando os resíduos padronizados
fit<-arima(retorno,order=c(1,0,0))
fit.res <- resid(fit)
modelo.N.ST.EVT <- garchFit( ~garch(1, 1), fit.res , cond.dist = "sstd")
sresi<-(modelo.N.ST.EVT@residuals/modelo.N.ST.EVT@sigma.t) 
#Passo2: Obtem-se sigma_t+1 e mu_t+1
mu.t1<- predict(fit, n.ahead=1)$pred[1]
sigma.t1<-predict(modelo.N.ST.EVT , n.ahead=1)[1,1]
#Passo3: Estima o quantil com base na distribuição GEV
library(fExtremes)
sresi.menos<- -sresi
MLE<- gevFit(sresi.menos,type="pwm")
xi<- MLE@fit$par.ests[1]
mu<-MLE@fit$par.ests[2]
sigma<-MLE@fit$par.ests[3]

#Passo4: Calcular o VaR
quantil<-qgev(lambda, xi = xi, mu = mu, beta = sigma, lower.tail = TRUE)
VaR.t1<- -(mu.t1+quantil[1]*sigma.t1)
VaR.t1
O VaR obtido para o método STEVT foi de $0.0006521516$. Graficamente, temos:
O código para a criação do gráfico de barras é:
VaR<-c(0.0006525116,0.0006524376,0.0006521597,0.0006521516)*100

mybarcol <- "gray20"
barplot(VaR, beside = TRUE,
 + col = c("lightblue", "mistyrose",
 +         "lightcyan", "lavender"),
 + legend = c("NFHS","STFHS","NEVT","STEVT"), 
 + main = "Value at Risk (VaR)", font.main = 4,
 + sub = "Petr4", col.sub = mybarcol, ylab="% VaR",
 + ylim= c(min(VaR),max(VaR)))

quinta-feira, 23 de agosto de 2012

Pacote quantmod - Análise quantitativa de séries financeiras.


O pacote quantmod é um pacote projetado para ajudar na análise quantitativa, desenvolvimento de testes e implantação de modelos de negócios com base estatística.

Após instalar o pacote, podemos fazer o download dos dados dos ativos PETR4.SA e PETR3.SA por meio do seguinte código:

#Habilita o pacote quantmod
library(quantmod)

#Cria um novo ambiente para armazenar os dados
stockData <- new.env() 

#Especifica as datas de interesse
startDate = as.Date("2010-01-01") 
endDate = as.Date("2011-12-31")
#Obtêm os dados do ativo PETR4 e PETR3
ativos<-c("PETR4.SA","PETR3.SA")
getSymbols(ativos, src="yahoo",from=startDate,to=endDate)
No comando acima, os dados dos ativos PETR4.SA e PETR3.SA são obtidos para as datas 01/01/2010 até 31/12/2011. A fonte desses dados é o Yahoo Finance. É possível, utilizar outras fontes como o Google Finance nesse caso basta trocar a opção src="yahoo" pela opção src="google".
#Usa o comando head para mostrar as seis primeiras observações
head(PETR4.SA)

#Plota a série temporal dos preços de fechamento
plot.xts(PETR4.SA$PETR4.SA.Close,major.format="%b/%d/%Y",
+main="PETR4.SA.",ylab="Close price.",xlab="Time")
O comando acima produz o seguinte gráfico:
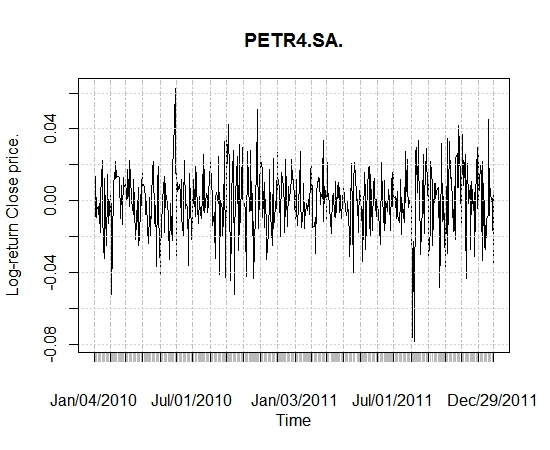
Usualmente, trabalha-se com a série diferenciada, ou seja, utiliza-se o log-retorno na forma: $\begin{array}{ll} r_{t}=&log\left(\frac{P_{t}}{P_{t-1}}\right)\end{array}$ onde $P_{t}$ é o preço do ativo no tempo $t$ e $log(.)$ é o logarítimo natural. O comado em R é escrito da seguinte forma:
#Calcula o log-retorno.
diffPETR4.SA<-diff(log(PETR4.SA))

#Plota a série temporal dos preços de fechamento
plot.xts(diffPETR4.SA$PETR4.SA.Close,major.format="%b/%d/%Y",
+main="PETR4.SA.",ylab="Log-return Close price.",xlab="Time")
Resultando no seguinte gráfico:
Pode-se trabalhar inclusive com um subconjunto de dados para uma determinada janela:
#Examinando apenas um mês de dados.
petrSubset<-  window(diffPETR4.SA, 
+start = as.Date("2011-05-01"), end = as.Date("2011-05-31"))
#Imprime os dados
petrSubset